阅读说明
学习参考的是李号双老师的 深入拆解Tomcat & Jetty,写的非常好。 但实际上我没有看完,我只看到第 22 章 (22 章看完),后面对我目前的帮助并不大。
1.Servlet规范和Servlet容器
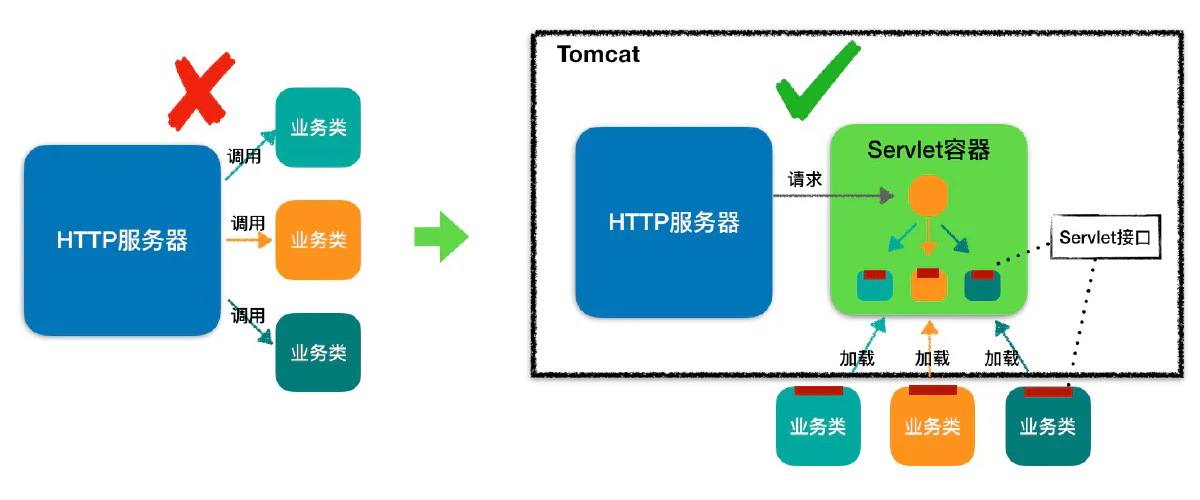
图的左边表示 HTTP 服务器直接调用具体业务类,它们是紧耦合的。再看图的右边,HTTP 服务器不直接调用业务类,而是把请求交给容器来处理,容器通过 Servlet 接口调用业务类。因此 Servlet 接口和 Servlet 容器的出现,达到了 HTTP 服务器与业务类解耦的目的。
而 Servlet 接口和 Servlet 容器这一整套规范叫作 Servlet 规范。Tomcat 和 Jetty 都按照 Servlet 规范的要求实现了 Servlet 容器,同时它们也具有 HTTP 服务器的功能。作为 Java 程序员,如果我们要实现新的业务功能,只需要实现一个 Servlet,并把它注册到 Tomcat(Servlet 容器)中,剩下的事情就由 Tomcat 帮我们处理了。
Servlet 接口
public interface Servlet {
    void init(ServletConfig config) throws ServletException;

    ServletConfig getServletConfig();

    void service(ServletRequest req, ServletResponse res)throws ServletException, IOException;

    String getServletInfo();

    void destroy();
}
其中最重要是的 service 方法,具体业务类在这个方法里实现处理逻辑。这个方法有两个参数:ServletRequest 和 ServletResponse。ServletRequest 用来封装请求信息,ServletResponse 用来封装响应信息,因此本质上这两个类是对通信协议的封装。
比如 HTTP 协议中的请求和响应就是对应了 HttpServletRequest 和 HttpServletResponse 这两个类。你可以通过 HttpServletRequest 来获取所有请求相关的信息,包括请求路径、Cookie、HTTP 头、请求参数等。此外,我在专栏上一期提到过,我们还可以通过 HttpServletRequest 来创建和获取 Session。而 HttpServletResponse 是用来封装 HTTP 响应的。
你可以看到接口中还有两个跟生命周期有关的方法 init 和 destroy,这是一个比较贴心的设计,Servlet 容器在加载 Servlet 类的时候会调用 init 方法,在卸载的时候会调用 destroy 方法。我们可能会在 init 方法里初始化一些资源,并在 destroy 方法里释放这些资源,比如 Spring MVC 中的 DispatcherServlet,就是在 init 方法里创建了自己的 Spring 容器。
你还会注意到 ServletConfig 这个类,ServletConfig 的作用就是封装 Servlet 的初始化参数。你可以在 web.xml 给 Servlet 配置参数,并在程序里通过 getServletConfig 方法拿到这些参数。
我们知道,有接口一般就有抽象类,抽象类用来实现接口和封装通用的逻辑,因此 Servlet 规范提供了 GenericServlet 抽象类,我们可以通过扩展它来实现 Servlet。虽然 Servlet 规范并不在乎通信协议是什么,但是大多数的 Servlet 都是在 HTTP 环境中处理的,因此 Servet 规范还提供了 HttpServlet 来继承 GenericServlet,并且加入了 HTTP 特性。这样我们通过继承 HttpServlet 类来实现自己的 Servlet,只需要重写两个方法:doGet 和 doPost。
Servlet 容器
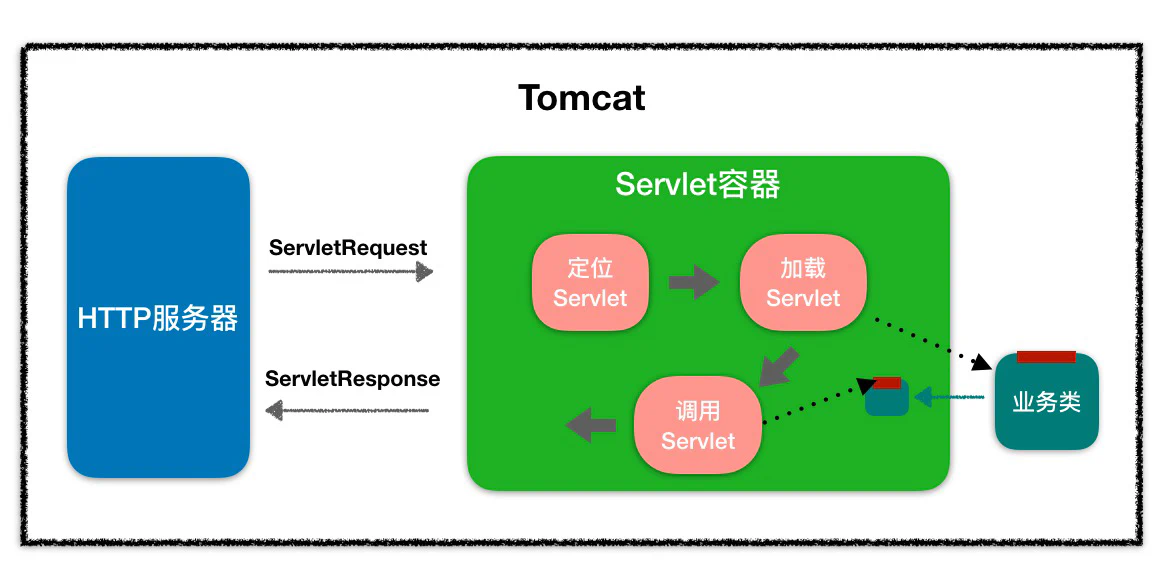
当客户请求某个资源时,HTTP 服务器会用一个 ServletRequest 对象把客户的请求信息封装起来,然后调用 Servlet 容器的 service 方法,Servlet 容器拿到请求后,根据请求的 URL 和 Servlet 的映射关系,找到相应的 Servlet,如果 Servlet 还没有被加载,就用反射机制创建这个 Servlet,并调用 Servlet 的 init 方法来完成初始化,接着调用 Servlet 的 service 方法来处理请求,把 ServletResponse 对象返回给 HTTP 服务器,HTTP 服务器会把响应发送给客户端。
Web 应用
Servlet 容器会实例化和调用 Servlet,那 Servlet 是怎么注册到 Servlet 容器中的呢?一般来说,我们是以 Web 应用程序的方式来部署 Servlet 的,而根据 Servlet 规范,Web 应用程序有一定的目录结构,在这个目录下分别放置了 Servlet 的类文件、配置文件以及静态资源,Servlet 容器通过读取配置文件,就能找到并加载 Servlet。Web 应用的目录结构大概是下面这样的:
| -  MyWebApp
      | -  WEB-INF/web.xml        -- 配置文件,用来配置 Servlet 等
      | -  WEB-INF/lib/           -- 存放 Web 应用所需各种 JAR 包
      | -  WEB-INF/classes/       -- 存放你的应用类,比如 Servlet 类
      | -  META-INF/              -- 目录存放工程的一些信息
Servlet 规范里定义了ServletContext这个接口来对应一个 Web 应用。Web 应用部署好后,Servlet 容器在启动时会加载 Web 应用,并为每个 Web 应用创建唯一的 ServletContext 对象。你可以把 ServletContext 看成是一个全局对象,一个 Web 应用可能有多个 Servlet,这些 Servlet 可以通过全局的 ServletContext 来共享数据,这些数据包括 Web 应用的初始化参数、Web 应用目录下的文件资源等。由于 ServletContext 持有所有 Servlet 实例,你还可以通过它来实现 Servlet 请求的转发。
扩展机制
Servlet 规范提供了两种扩展机制:Filter和Listener。
Filter是过滤器,这个接口允许你对请求和响应做一些统一的定制化处理,比如你可以根据请求的频率来限制访问,或者根据国家地区的不同来修改响应内容。过滤器的工作原理是这样的:Web 应用部署完成后,Servlet 容器需要实例化 Filter 并把 Filter 链接成一个 FilterChain。当请求进来时,获取第一个 Filter 并调用 doFilter 方法,doFilter 方法负责调用这个 FilterChain 中的下一个 Filter。
Listener是监听器,这是另一种扩展机制。当 Web 应用在 Servlet 容器中运行时,Servlet 容器内部会不断的发生各种事件,如 Web 应用的启动和停止、用户请求到达等。 Servlet 容器提供了一些默认的监听器来监听这些事件,当事件发生时,Servlet 容器会负责调用监听器的方法。当然,你可以定义自己的监听器去监听你感兴趣的事件,将监听器配置在 web.xml 中。比如 Spring 就实现了自己的监听器,来监听 ServletContext 的启动事件,目的是当 Servlet 容器启动时,创建并初始化全局的 Spring 容器。
在书架中单独阅读「1.Servlet规范和Servlet容器」→
2.运行一个Servlet
今天我们就抛弃 IDE、拒绝框架,自己纯手工编写一个 Servlet,并在 Tomcat 中运行起来。一方面进一步加深对 Servlet 的理解;另一方面,还可以熟悉一下 Tomcat 的基本功能使用。
主要的步骤有:
- 下载并安装 Tomcat。
- 编写一个继承 HttpServlet 的 Java 类。
- 将 Java 类文件编译成 Class 文件。
- 建立 Web 应用的目录结构,并配置 web.xml。
- 部署 Web 应用。
- 启动 Tomcat。
- 浏览器访问验证结果。
- 查看 Tomcat 日志。
动手时间
- 安装 tomcat
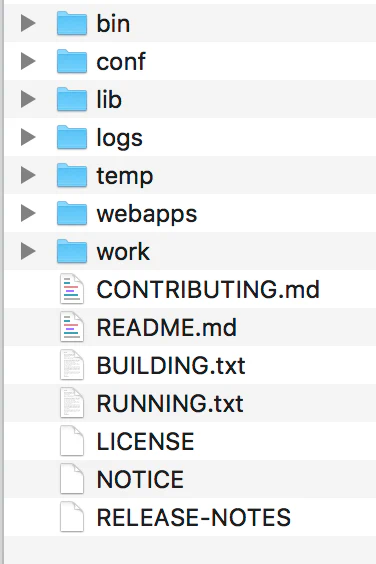
/bin:存放 Windows 或 Linux 平台上启动和关闭 Tomcat 的脚本文件。
/conf:存放 Tomcat 的各种全局配置文件,其中最重要的是 server.xml。
/lib:存放 Tomcat 以及所有 Web 应用都可以访问的 JAR 文件。
/logs:存放 Tomcat 执行时产生的日志文件。
/work:存放 JSP 编译后产生的 Class 文件。
/webapps:Tomcat 的 Web 应用目录,默认情况下把 Web 应用放在这个目录下。
- 编写一个继承 HttpServlet 的 Java 类
javax.servlet 包提供了实现 Servlet 接口的 GenericServlet 抽象类。这是一个比较方便的类,可以通过扩展它来创建 Servlet。但是大多数的 Servlet 都在 HTTP 环境中处理请求,因此 Serve 规范还提供了 HttpServlet 来扩展 GenericServlet 并且加入了 HTTP 特性。我们通过继承 HttpServlet 类来实现自己的 Servlet 只需要重写两个方法:doGet 和 doPost。
因此今天我们创建一个 Java 类去继承 HttpServlet 类,并重写 doGet 和 doPost 方法。首先新建一个名为 MyServlet.java 的文件,敲入下面这些代码:
import java.io.IOException;
import java.io.PrintWriter;

import javax.servlet.ServletException;
import javax.servlet.http.HttpServlet;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;


public class MyServlet extends HttpServlet {

    @Override
    protected void doGet(HttpServletRequest request, HttpServletResponse response)
            throws ServletException, IOException {

        System.out.println("MyServlet 在处理 get()请求...");
        PrintWriter out = response.getWriter();
        response.setContentType("text/html;charset=utf-8");
        out.println("<strong>My Servlet!</strong><br>");
    }

    @Override
    protected void doPost(HttpServletRequest request, HttpServletResponse response)
            throws ServletException, IOException {

        System.out.println("MyServlet 在处理 post()请求...");
        PrintWriter out = response.getWriter();
        response.setContentType("text/html;charset=utf-8");
        out.println("<strong>My Servlet!</strong><br>");
    }

}
这个 Servlet 完成的功能很简单,分别在 doGet 和 doPost 方法体里返回一段简单的 HTML。
- 将 Java 文件编译成 Class 文件
javac -cp ./servlet-api.jar MyServlet.java
编译成功后,你会在当前目录下找到一个叫 MyServlet.class 的文件。
- 建立 Web 应用的目录结构
Servlet 是放到 Web 应用部署到 Tomcat 的,而 Web 应用具有一定的目录结构,所有我们按照要求建立 Web 应用文件夹,名字叫 MyWebApp,然后在这个目录下建立子文件夹,像下面这样:
MyWebApp/WEB-INF/web.xml

MyWebApp/WEB-INF/classes/MyServlet.class
然后在 web.xml 中配置 Servlet,内容如下:
<?xml version="1.0" encoding="UTF-8"?>
<web-app xmlns="http://xmlns.jcp.org/xml/ns/javaee"
  xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
  xsi:schemaLocation="http://xmlns.jcp.org/xml/ns/javaee
  http://xmlns.jcp.org/xml/ns/javaee/web-app_4_0.xsd"
  version="4.0"
  metadata-complete="true">

    <description> Servlet Example. </description>
    <display-name> MyServlet Example </display-name>
    <request-character-encoding>UTF-8</request-character-encoding>

    <servlet>
      <servlet-name>myServlet</servlet-name>
      <servlet-class>MyServlet</servlet-class>
    </servlet>

    <servlet-mapping>
      <servlet-name>myServlet</servlet-name>
      <url-pattern>/myservlet</url-pattern>
    </servlet-mapping>

</web-app>
你可以看到在 web.xml 配置了 Servlet 的名字和具体的类,以及这个 Servlet 对应的 URL 路径。请你注意,servlet 和 servlet-mapping 这两个标签里的 servlet-name 要保持一致。
- 部署 Web 应用
Tomcat 应用的部署非常简单,将这个目录 MyWebApp 拷贝到 Tomcat 的安装目录下的 webapps 目录即可。 - 启动 Tomcat
找到 Tomcat 安装目录下的 bin 目录,根据操作系统的不同,执行相应的启动脚本。如果是 Windows 系统,执行<font style="color:rgb(53, 53, 53);">startup.bat</font>.;如果是 Linux 系统,则执行<font style="color:rgb(53, 53, 53);">startup.sh</font>。 - 验证结果
****访问: URL:<font style="color:rgb(53, 53, 53);">http://localhost:8080/MyWebApp/myservlet</font>
这里需要注意,访问 URL 路径中的 MyWebApp 是 Web 应用的名字,myservlet 是在 web.xml 里配置的 Servlet 的路径。 - 查看 Tomcat 日志
打开 Tomcat 的日志目录,也就是 Tomcat 安装目录下的 logs 目录。Tomcat 的日志信息分为两类 :一是运行日志,它主要记录运行过程中的一些信息,尤其是一些异常错误日志信息 ;二是访问日志,它记录访问的时间、IP 地址、访问的路径等相关信息。
这里简要介绍各个文件的含义。
<font style="color:rgb(53, 53, 53);">catalina.***.log</font>
主要是记录 Tomcat 启动过程的信息,在这个文件可以看到启动的 JVM 参数以及操作系统等日志信息。
<font style="color:rgb(53, 53, 53);">catalina.out</font>
catalina.out 是 Tomcat 的标准输出(stdout)和标准错误(stderr),这是在 Tomcat 的启动脚本里指定的,如果没有修改的话 stdout 和 stderr 会重定向到这里。所以在这个文件里可以看到我们在 MyServlet.java 程序里打印出来的信息:
MyServlet 在处理 get() 请求…
<font style="color:rgb(53, 53, 53);">localhost.**.log</font>
主要记录 Web 应用在初始化过程中遇到的未处理的异常,会被 Tomcat 捕获而输出这个日志文件。
<font style="color:rgb(53, 53, 53);">localhost_access_log.**.txt</font>
存放访问 Tomcat 的请求日志,包括 IP 地址以及请求的路径、时间、请求协议以及状态码等信息。
<font style="color:rgb(53, 53, 53);">manager.***.log/host-manager.***.log</font>
存放 Tomcat 自带的 manager 项目的日志信息。
用注解试试看
用注解的方式部署 Servlet
我们首先修改 Java 代码,给 Servlet 类加上@WebServlet注解,修改后的代码如下。
import java.io.IOException;
import java.io.PrintWriter;

import javax.servlet.ServletException;
import javax.servlet.annotation.WebServlet;
import javax.servlet.http.HttpServlet;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;

@WebServlet("/myAnnotationServlet")
public class AnnotationServlet extends HttpServlet {

    @Override
    protected void doGet(HttpServletRequest request, HttpServletResponse response)
            throws ServletException, IOException {

   System.out.println("AnnotationServlet 在处理 get()请求...");
        PrintWriter out = response.getWriter();
        response.setContentType("text/html; charset=utf-8");
        out.println("<strong>Annotation Servlet!</strong><br>");

    }

    @Override
    protected void doPost(HttpServletRequest request, HttpServletResponse response)
            throws ServletException, IOException {

        System.out.println("AnnotationServlet 在处理 post()请求...");
        PrintWriter out = response.getWriter();
        response.setContentType("text/html; charset=utf-8");
        out.println("<strong>Annotation Servlet!</strong><br>");

    }

}
这段代码里最关键的就是这个注解,它表明两层意思:第一层意思是 AnnotationServlet 这个 Java 类是一个 Servlet,第二层意思是这个 Servlet 对应的 URL 路径是 myAnnotationServlet。
@WebServlet("/myAnnotationServlet")
创建好 Java 类以后,同样经过编译,并放到 MyWebApp 的 class 目录下。这里要注意的是,你需要删除原来的 web.xml,因为我们不需要 web.xml 来配置 Servlet 了。然后重启 Tomcat,接下来我们验证一下这个新的 AnnotationServlet 有没有部署成功。在浏览器里输入:<font style="color:rgb(53, 53, 53);">http://localhost:8080/MyWebApp/myAnnotationServlet</font>,得到结果:Annotation Servlet!
这说明我们的 AnnotationServlet 部署成功了。可以通过注解完成 web.xml 所有的配置功能,包括 Servlet 初始化参数以及配置 Filter 和 Listener 等。
我的 tiny-tomcat
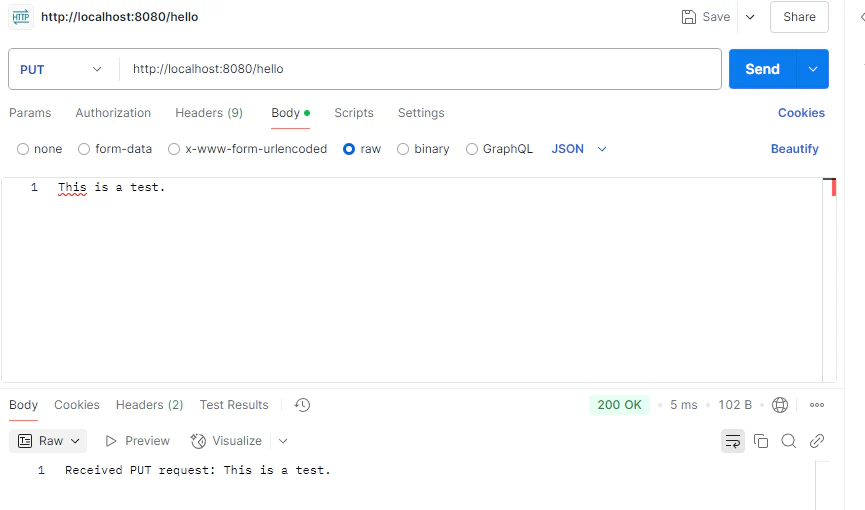
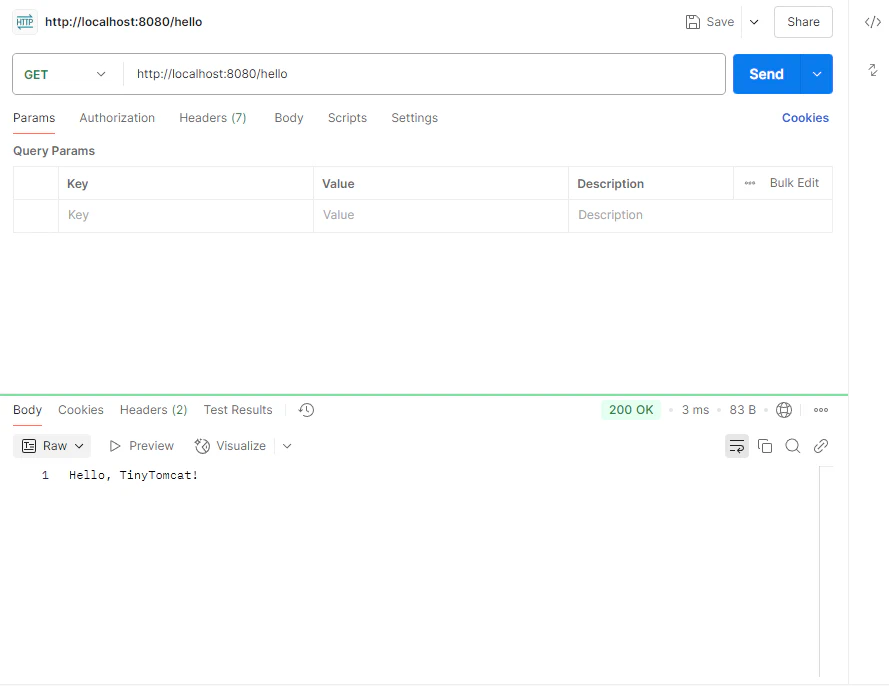
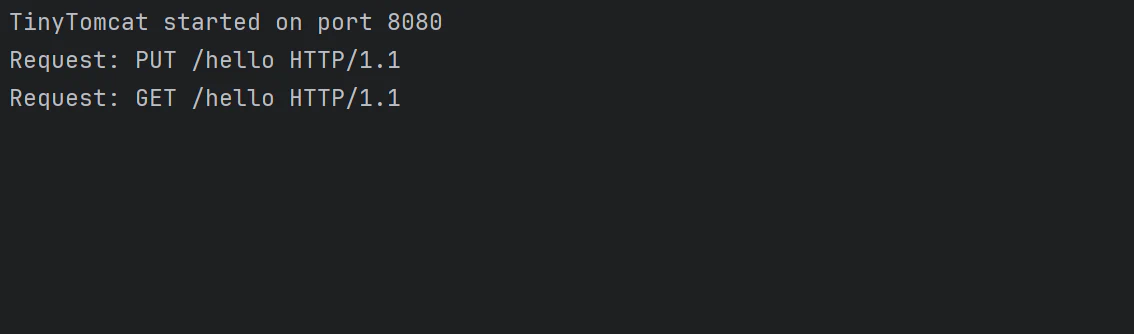
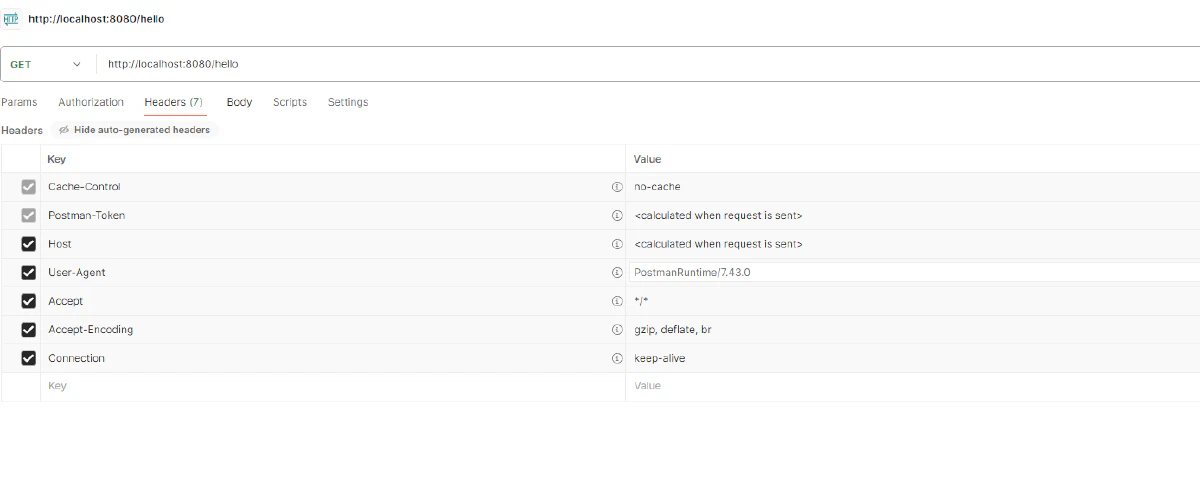
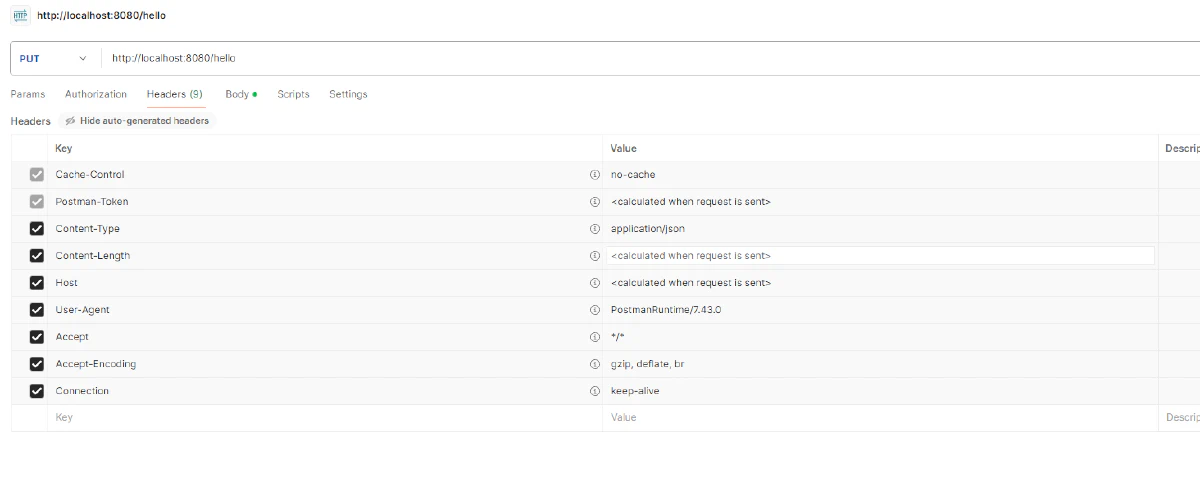
put 和 get 中 header 数量的对比
几个问题
- Servlet 3.0 规范支持用注解的方式来部署 Servlet,不需要在 web.xml 里配置,而如果要注解和 web.xml 一起用,需要将 web.xml中的配置
metadata-complete="true", 你需要把它设置成metadata-complete="false"。 - response.setContentType(“text/html;charset=utf-8”)发现中文输出还是乱码
调下顺序,像下面这样:
response.setContentType(“text/html; charset=utf-8”);
PrintWriter out = response.getWriter();getWrite的源码如下:
public PrintWriter getWriter()
throws IOException {

if (usingOutputStream) {
    throw new IllegalStateException
    (sm.getString("coyoteResponse.getWriter.ise"));
}

if (ENFORCE_ENCODING_IN_GET_WRITER) {
    /*
         * If the response's character encoding has not been specified as
         * described in <code>getCharacterEncoding</code> (i.e., the method
         * just returns the default value <code>ISO-8859-1</code>),
         * <code>getWriter</code> updates it to <code>ISO-8859-1</code>
         * (with the effect that a subsequent call to getContentType() will
         * include a charset=ISO-8859-1 component which will also be
         * reflected in the Content-Type response header, thereby satisfying
         * the Servlet spec requirement that containers must communicate the
         * character encoding used for the servlet response's writer to the
         * client).
         */
    setCharacterEncoding(getCharacterEncoding());
}

usingWriter = true;
outputBuffer.checkConverter();
if (writer == null) {
    writer = new CoyoteWriter(outputBuffer);
}
return writer;
}
你看注释里它说:如果调这个方法之前没有指定Response的字符编码,就用默认的ISO-8859-1,ISO-8859-1不包括中文字符。
- 和 spring mvc 中有什么关系呢?
Tomcat的Wrapper组件-Filter-DispatcherServlet-Controller
3.tomcat架构
我们已经了解了 Tomcat 要实现 2 个核心功能:
- 处理 Socket 连接,负责网络字节流与 Request 和 Response 对象的转化。
- 加载和管理 Servlet,以及具体处理 Request 请求。
因此 Tomcat 设计了两个核心组件连接器(Connector)和容器(Container)来分别做这两件事情。连接器负责对外交流,容器负责内部处理。
连接器
Tomcat 支持多种 I/O 模型和应用层协议。
Tomcat 支持的 I/O 模型有:
- NIO:非阻塞 I/O,采用 Java NIO 类库实现。
- NIO2:异步 I/O,采用 JDK 7 最新的 NIO2 类库实现。
- APR:采用 Apache 可移植运行库实现,是 C/C++ 编写的本地库。
Tomcat 支持的应用层协议有:
- HTTP/1.1:这是大部分 Web 应用采用的访问协议。
- AJP:用于和 Web 服务器集成(如 Apache)。
- HTTP/2:HTTP 2.0 大幅度的提升了 Web 性能。
Tomcat 为了实现支持多种 I/O 模型和应用层协议,一个容器可能对接多个连接器,就好比一个房间有多个门。但是单独的连接器或者容器都不能对外提供服务,需要把它们组装起来才能工作,组装后这个整体叫作 Service 组件。这里请你注意,Service 本身没有做什么重要的事情,只是在连接器和容器外面多包了一层,把它们组装在一起。Tomcat 内可能有多个 Service,这样的设计也是出于灵活性的考虑。通过在 Tomcat 中配置多个 Service,可以实现通过不同的端口号来访问同一台机器上部署的不同应用。
到此我们得到这样一张关系图:
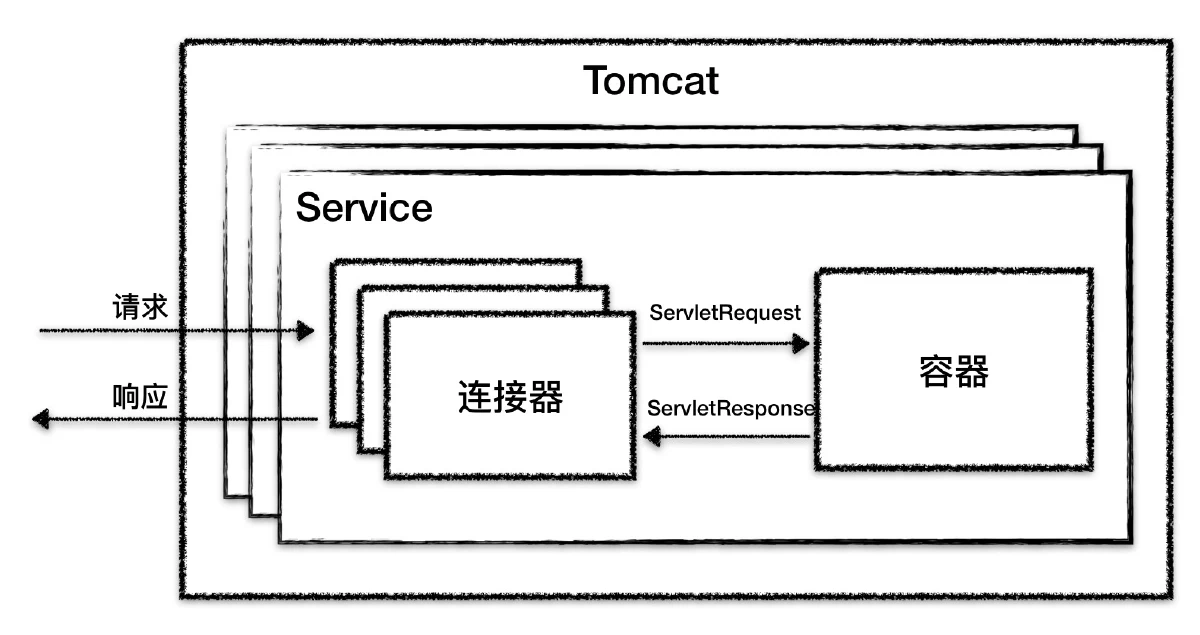
从图上你可以看到,最顶层是 Server,这里的 Server 指的就是一个 Tomcat 实例。一个 Server 中有一个或者多个 Service,一个 Service 中有多个连接器和一个容器。连接器与容器之间通过标准的 ServletRequest 和 ServletResponse 通信。
连接器对 Servlet 容器屏蔽了协议及 I/O 模型等的区别,无论是 HTTP 还是 AJP,在容器中获取到的都是一个标准的 ServletRequest 对象。
通过分析连接器的详细功能列表,我们发现连接器需要完成 3 个高内聚的功能:
- 网络通信。
- 应用层协议解析。
- Tomcat Request/Response 与 ServletRequest/ServletResponse 的转化。
因此 Tomcat 的设计者设计了 3 个组件来实现这 3 个功能,分别是 EndPoint、Processor 和 Adapter。
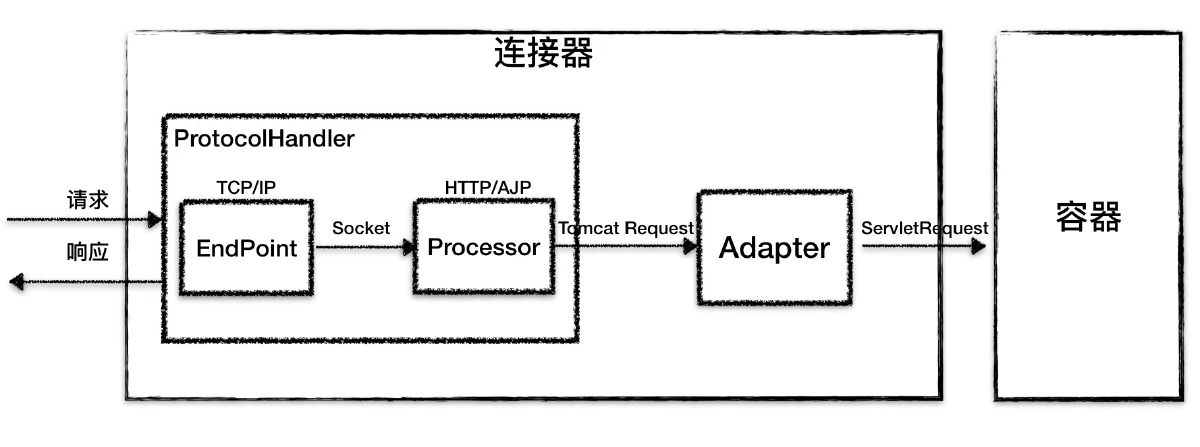
顶层组件有两个: ProtocolHandler 和 Adapter。
ProtocolHandler 组件
由上文我们知道,连接器用 ProtocolHandler 来处理网络连接和应用层协议,包含了 2 个重要部件:EndPoint 和 Processor。
EndPoint
EndPoint 是通信端点,即通信监听的接口,是具体的 Socket 接收和发送处理器,是对传输层的抽象,因此 EndPoint 是用来实现 TCP/IP 协议的。
EndPoint 是一个接口,对应的抽象实现类是 AbstractEndpoint,而 AbstractEndpoint 的具体子类,比如在 NioEndpoint 和 Nio2Endpoint 中,有两个重要的子组件:Acceptor 和 SocketProcessor。
其中 Acceptor 用于监听 Socket 连接请求。SocketProcessor 用于处理接收到的 Socket 请求,它实现 Runnable 接口,在 Run 方法里调用协议处理组件 Processor 进行处理。为了提高处理能力,SocketProcessor 被提交到线程池来执行。而这个线程池叫作执行器(Executor)。
Processor
如果说 EndPoint 是用来实现 TCP/IP 协议的,那么 Processor 用来实现 HTTP 协议,Processor 接收来自 EndPoint 的 Socket,读取字节流解析成 Tomcat Request 和 Response 对象,并通过 Adapter 将其提交到容器处理,Processor 是对应用层协议的抽象。
Processor 是一个接口,定义了请求的处理等方法。它的抽象实现类 AbstractProcessor 对一些协议共有的属性进行封装,没有对方法进行实现。具体的实现有 AJPProcessor、HTTP11Processor 等,这些具体实现类实现了特定协议的解析方法和请求处理方式。
我们再来看看连接器的组件图:
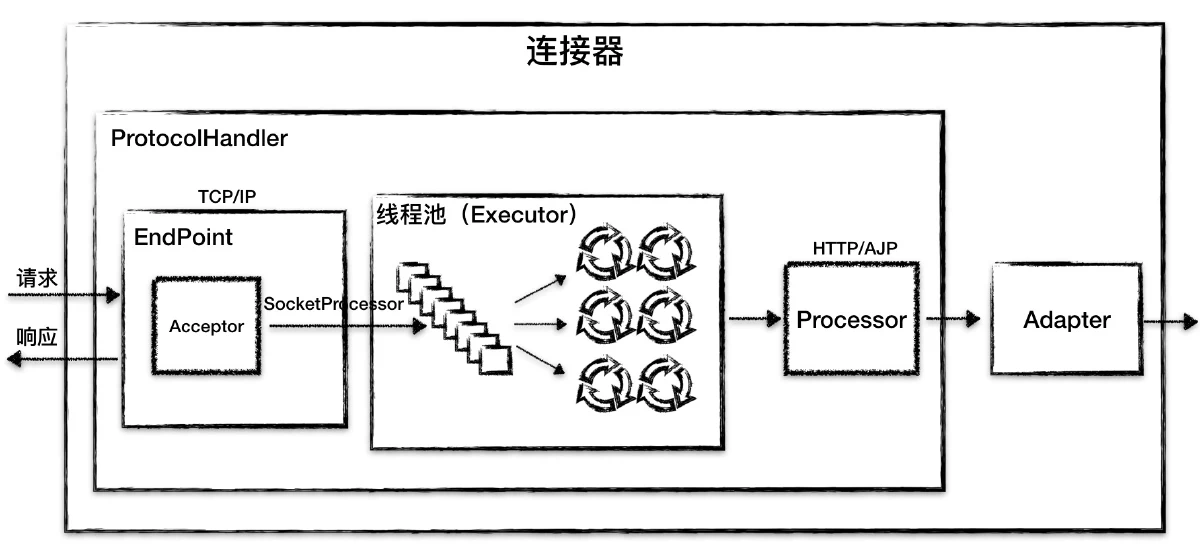
从图中我们看到,EndPoint 接收到 Socket 连接后,生成一个 SocketProcessor 任务提交到线程池去处理,SocketProcessor 的 Run 方法会调用 Processor 组件去解析应用层协议,Processor 通过解析生成 Request 对象后,会调用 Adapter 的 Service 方法。
Adapter 组件
我在前面说过,由于协议不同,客户端发过来的请求信息也不尽相同,Tomcat 定义了自己的 Request 类来“存放”这些请求信息。ProtocolHandler 接口负责解析请求并生成 Tomcat Request 类。但是这个 Request 对象不是标准的 ServletRequest,也就意味着,不能用 Tomcat Request 作为参数来调用容器。Tomcat 设计者的解决方案是引入 CoyoteAdapter,这是适配器模式的经典运用,连接器调用 CoyoteAdapter 的 Sevice 方法,传入的是 Tomcat Request 对象,CoyoteAdapter 负责将 Tomcat Request 转成 ServletRequest,再调用容器的 Service 方法。
总结一下
Tomcat 的整体架构包含了两个核心组件连接器和容器。连接器负责对外交流,容器负责内部处理。连接器用 ProtocolHandler 接口来封装通信协议和 I/O 模型的差异,ProtocolHandler 内部又分为 EndPoint 和 Processor 模块,EndPoint 负责底层 Socket 通信,Proccesor 负责应用层协议解析。连接器通过适配器 Adapter 调用容器。
不错的问题
- tomcat和netty有什么区别呢?为什么netty常常用做底层通讯模块,而tomcat作为web容器呢?
你可以把Netty理解成Tomcat中的连接器,它们都负责网络通信,都利用了Java NIO非阻塞特性。但Netty素以高性能高并发著称,为什么Tomcat不把连接器替换成Netty呢?第一个原因是Tomcat的连接器性能已经足够好了,同样是Java NIO编程,套路都差不多。第二个原因是Tomcat做为Web容器,需要考虑到Servlet规范,Servlet规范规定了对HTTP Body的读写是阻塞的,因此即使用到了Netty,也不能充分发挥它的优势。所以Netty一般用在非HTTP协议和Servlet的场景下。 - 请求来的时候,源码入口在哪里?
在Acceptor的run方法里:
socket = endpoint.serverSocketAccept();
这句话用来接收一个新的连接
容器
Tomcat 设计了 4 种容器,分别是 Engine、Host、Context 和 Wrapper。这 4 种容器不是平行关系,而是父子关系。下面我画了一张图帮你理解它们的关系。
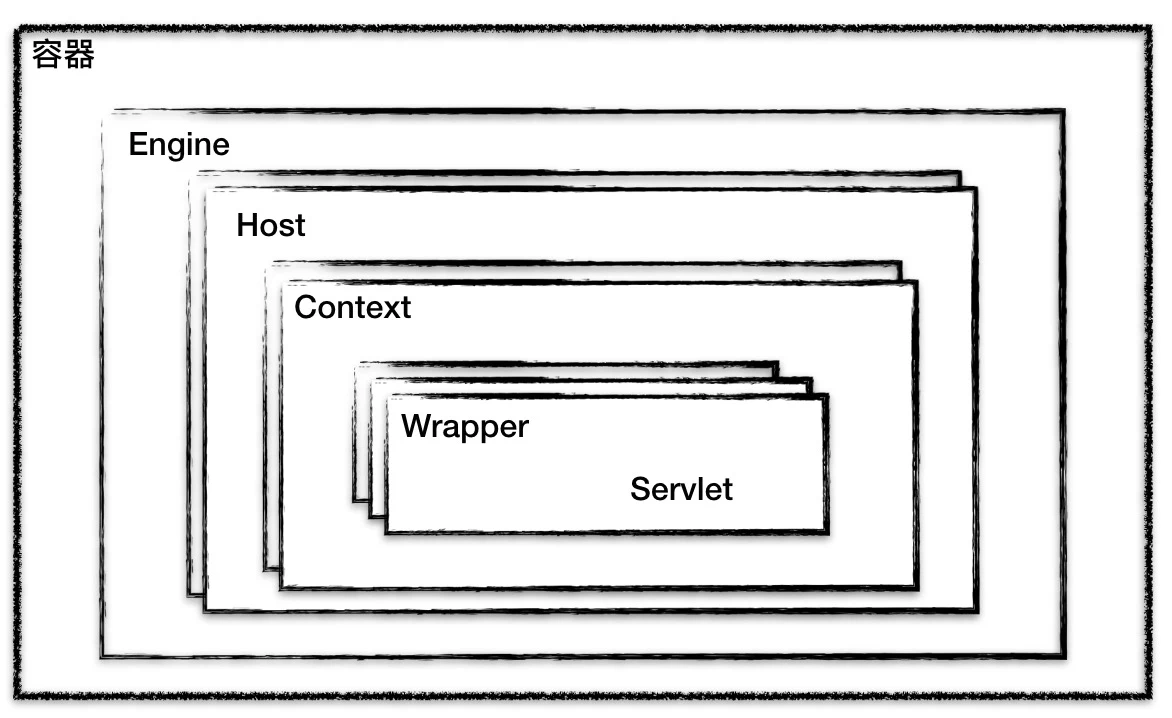
Tomcat 通过一种分层的架构,使得 Servlet 容器具有很好的灵活性。
Context 表示一个 Web 应用程序;Wrapper 表示一个 Servlet,一个 Web 应用程序中可能会有多个 Servlet;Host 代表的是一个虚拟主机,或者说一个站点,可以给 Tomcat 配置多个虚拟主机地址,而一个虚拟主机下可以部署多个 Web 应用程序;Engine 表示引擎,用来管理多个虚拟站点,一个 Service 最多只能有一个 Engine。
你可以再通过 Tomcat 的 server.xml 配置文件来加深对 Tomcat 容器的理解。Tomcat 采用了组件化的设计,它的构成组件都是可配置的,其中最外层的是 Server,其他组件按照一定的格式要求配置在这个顶层容器中。
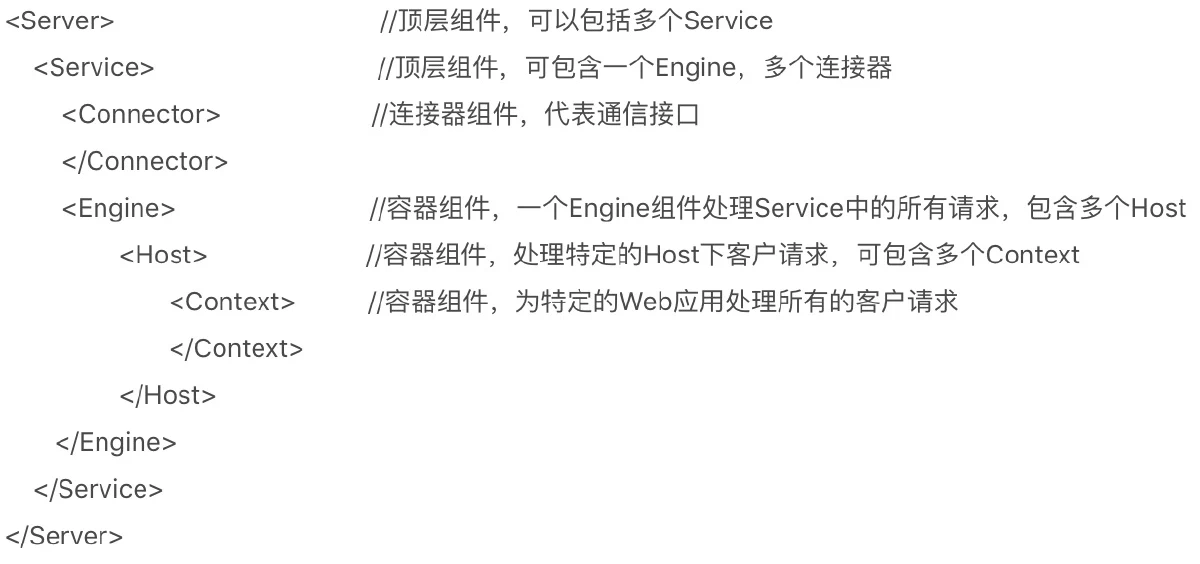
那么,Tomcat 是怎么管理这些容器的呢?你会发现这些容器具有父子关系,形成一个树形结构,你可能马上就想到了设计模式中的组合模式。没错,Tomcat 就是用组合模式来管理这些容器的。具体实现方法是,所有容器组件都实现了 Container 接口,因此组合模式可以使得用户对单容器对象和组合容器对象的使用具有一致性。这里单容器对象指的是最底层的 Wrapper,组合容器对象指的是上面的 Context、Host 或者 Engine。Container 接口定义如下:
public interface Container extends Lifecycle {
    public void setName(String name);
    public Container getParent();
    public void setParent(Container container);
    public void addChild(Container child);
    public void removeChild(Container child);
    public Container findChild(String name);
}
正如我们期望的那样,我们在上面的接口看到了 getParent、SetParent、addChild 和 removeChild 等方法。你可能还注意到 Container 接口扩展了 LifeCycle 接口,LifeCycle 接口用来统一管理各组件的生命周期,这里暂时不讲。
请求定位 Servlet 的过程
你可能好奇,设计了这么多层次的容器,Tomcat 是怎么确定请求是由哪个 Wrapper 容器里的 Servlet 来处理的呢?答案是,Tomcat 是用 Mapper 组件来完成这个任务的。
Mapper 组件的功能就是将用户请求的 URL 定位到一个 Servlet,它的工作原理是:Mapper 组件里保存了 Web 应用的配置信息,其实就是容器组件与访问路径的映射关系,比如 Host 容器里配置的域名、Context 容器里的 Web 应用路径,以及 Wrapper 容器里 Servlet 映射的路径,你可以想象这些配置信息就是一个多层次的 Map。
当一个请求到来时,Mapper 组件通过解析请求 URL 里的域名和路径,再到自己保存的 Map 里去查找,就能定位到一个 Servlet。请你注意,一个请求 URL 最后只会定位到一个 Wrapper 容器,也就是一个 Servlet。
读到这里你可能感到有些抽象,接下来我通过一个例子来解释这个定位的过程。
假如有一个网购系统,有面向网站管理人员的后台管理系统,还有面向终端客户的在线购物系统。这两个系统跑在同一个 Tomcat 上,为了隔离它们的访问域名,配置了两个虚拟域名:<font style="color:rgb(53, 53, 53);">manage.shopping.com</font>和<font style="color:rgb(53, 53, 53);">user.shopping.com</font>,网站管理人员通过<font style="color:rgb(53, 53, 53);">manage.shopping.com</font>域名访问 Tomcat 去管理用户和商品,而用户管理和商品管理是两个单独的 Web 应用。终端客户通过<font style="color:rgb(53, 53, 53);">user.shopping.com</font>域名去搜索商品和下订单,搜索功能和订单管理也是两个独立的 Web 应用。
针对这样的部署,Tomcat 会创建一个 Service 组件和一个 Engine 容器组件,在 Engine 容器下创建两个 Host 子容器,在每个 Host 容器下创建两个 Context 子容器。由于一个 Web 应用通常有多个 Servlet,Tomcat 还会在每个 Context 容器里创建多个 Wrapper 子容器。每个容器都有对应的访问路径,你可以通过下面这张图来帮助你理解。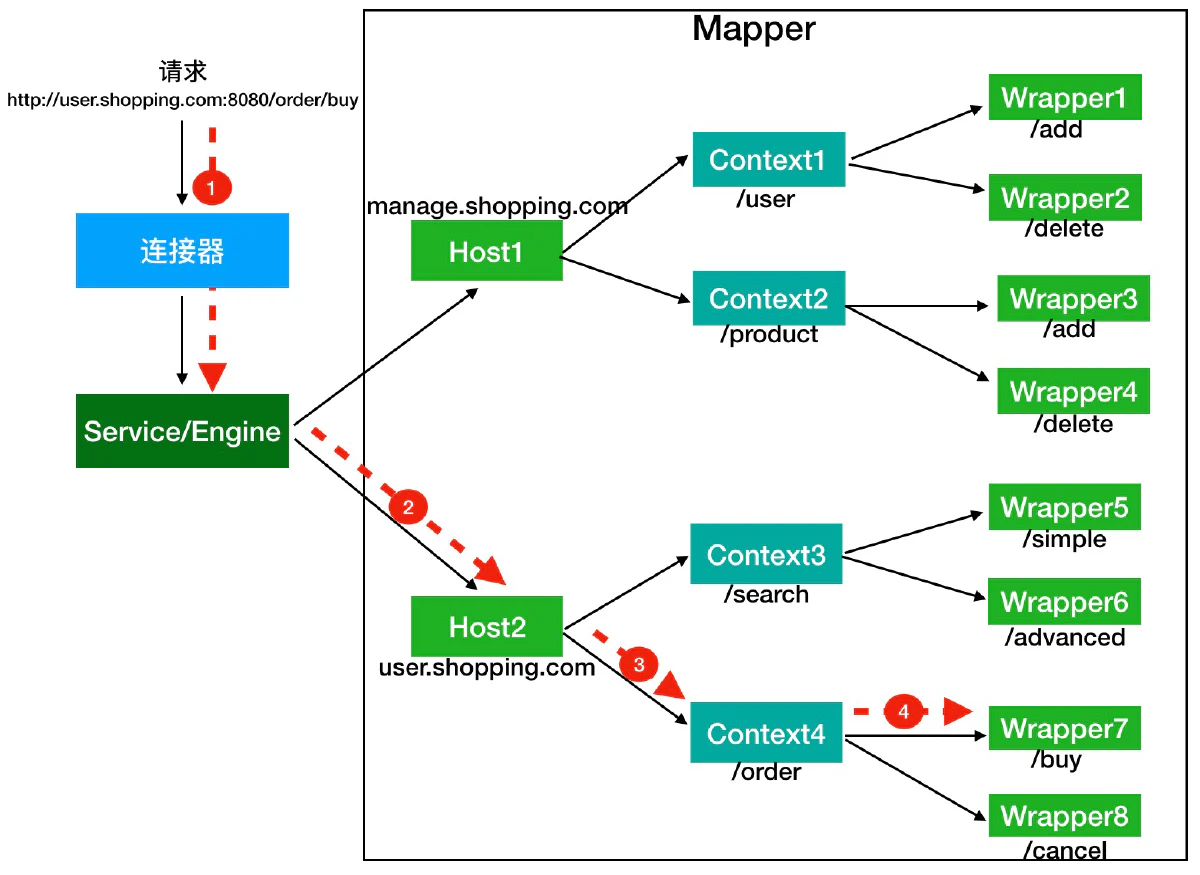
假如有用户访问一个 URL,比如图中的<font style="color:rgb(53, 53, 53);">http://user.shopping.com:8080/order/buy</font>,Tomcat 如何将这个 URL 定位到一个 Servlet 呢?
首先,根据协议和端口号选定 Service 和 Engine。
我们知道 Tomcat 的每个连接器都监听不同的端口,比如 Tomcat 默认的 HTTP 连接器监听 8080 端口、默认的 AJP 连接器监听 8009 端口。上面例子中的 URL 访问的是 8080 端口,因此这个请求会被 HTTP 连接器接收,而一个连接器是属于一个 Service 组件的,这样 Service 组件就确定了。我们还知道一个 Service 组件里除了有多个连接器,还有一个容器组件,具体来说就是一个 Engine 容器,因此 Service 确定了也就意味着 Engine 也确定了。
然后,根据域名选定 Host。
Service 和 Engine 确定后,Mapper 组件通过 URL 中的域名去查找相应的 Host 容器,比如例子中的 URL 访问的域名是<font style="color:rgb(53, 53, 53);">user.shopping.com</font>,因此 Mapper 会找到 Host2 这个容器。
之后,根据 URL 路径找到 Context 组件。
Host 确定以后,Mapper 根据 URL 的路径来匹配相应的 Web 应用的路径,比如例子中访问的是 /order,因此找到了 Context4 这个 Context 容器。
最后,根据 URL 路径找到 Wrapper(Servlet)。
Context 确定后,Mapper 再根据 web.xml 中配置的 Servlet 映射路径来找到具体的 Wrapper 和 Servlet。
看到这里,我想你应该已经了解了什么是容器,以及 Tomcat 如何通过一层一层的父子容器找到某个 Servlet 来处理请求。需要注意的是,并不是说只有 Servlet 才会去处理请求,实际上这个查找路径上的父子容器都会对请求做一些处理。我在上一期说过,连接器中的 Adapter 会调用容器的 Service 方法来执行 Servlet,最先拿到请求的是 Engine 容器,Engine 容器对请求做一些处理后,会把请求传给自己子容器 Host 继续处理,依次类推,最后这个请求会传给 Wrapper 容器,Wrapper 会调用最终的 Servlet 来处理。那么这个调用过程具体是怎么实现的呢?答案是使用 Pipeline-Valve 管道。
Pipeline-Valve 是责任链模式,责任链模式是指在一个请求处理的过程中有很多处理者依次对请求进行处理,每个处理者负责做自己相应的处理,处理完之后将再调用下一个处理者继续处理。
Valve 表示一个处理点,比如权限认证和记录日志。如果你还不太理解的话,可以来看看 Valve 和 Pipeline 接口中的关键方法。
public interface Valve {
  public Valve getNext();
  public void setNext(Valve valve);
  public void invoke(Request request, Response response)
}
由于 Valve 是一个处理点,因此 invoke 方法就是来处理请求的。注意到 Valve 中有 getNext 和 setNext 方法,因此我们大概可以猜到有一个链表将 Valve 链起来了。请你继续看 Pipeline 接口:
public interface Pipeline extends Contained {
    public void addValve(Valve valve);
    public Valve getBasic();
    public void setBasic(Valve valve);
    public Valve getFirst();
}
没错,Pipeline 中有 addValve 方法。Pipeline 中维护了 Valve 链表,Valve 可以插入到 Pipeline 中,对请求做某些处理。我们还发现 Pipeline 中没有 invoke 方法,因为整个调用链的触发是 Valve 来完成的,Valve 完成自己的处理后,调用 getNext.invoke() 来触发下一个 Valve 调用。
每一个容器都有一个 Pipeline 对象,只要触发这个 Pipeline 的第一个 Valve,这个容器里 Pipeline 中的 Valve 就都会被调用到。但是,不同容器的 Pipeline 是怎么链式触发的呢,比如 Engine 中 Pipeline 需要调用下层容器 Host 中的 Pipeline。
这是因为 Pipeline 中还有个 getBasic 方法。这个 BasicValve 处于 Valve 链表的末端,它是 Pipeline 中必不可少的一个 Valve,负责调用下层容器的 Pipeline 里的第一个 Valve。我还是通过一张图来解释。
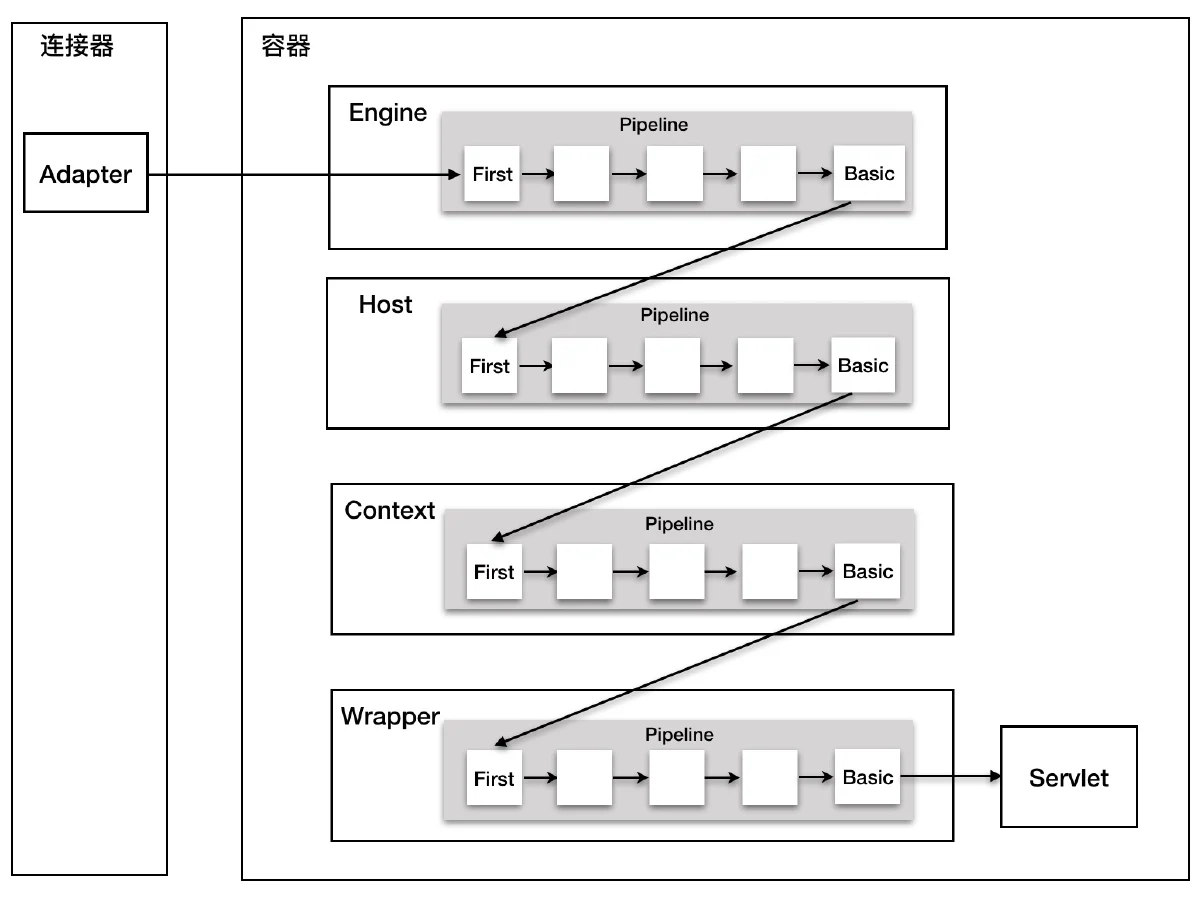
整个调用过程由连接器中的 Adapter 触发的,它会调用 Engine 的第一个 Valve:
// Calling the container
connector.getService().getContainer().getPipeline().getFirst().invoke(request, response);
Wrapper 容器的最后一个 Valve 会创建一个 Filter 链,并调用 doFilter() 方法,最终会调到 Servlet 的 service 方法。
你可能会问,前面我们不是讲到了 Filter,似乎也有相似的功能,那 Valve 和 Filter 有什么区别吗?它们的区别是:
- Valve 是 Tomcat 的私有机制,与 Tomcat 的基础架构 /API 是紧耦合的。Servlet API 是公有的标准,所有的 Web 容器包括 Jetty 都支持 Filter 机制。
- 另一个重要的区别是 Valve 工作在 Web 容器级别,拦截所有应用的请求;而 Servlet Filter 工作在应用级别,只能拦截某个 Web 应用的所有请求。如果想做整个 Web 容器的拦截器,必须通过 Valve 来实现。
总结一下
今天我们学习了 Tomcat 容器的层次结构、根据请求定位 Servlet 的过程,以及请求在容器中的调用过程。Tomcat 设计了多层容器是为了灵活性的考虑,灵活性具体体现在一个 Tomcat 实例(Server)可以有多个 Service,每个 Service 通过多个连接器监听不同的端口,而一个 Service 又可以支持多个虚拟主机。一个 URL 网址可以用不同的主机名、不同的端口和不同的路径来访问特定的 Servlet 实例。
请求的链式调用是基于 Pipeline-Valve 责任链来完成的,这样的设计使得系统具有良好的可扩展性,如果需要扩展容器本身的功能,只需要增加相应的 Valve 即可。
不错的问题
- 业务中的 controller 是怎么进来的
上一节就有过,Wrapper - Filter - DispatcherServlet - Controller - Tomcat 内的 Context 组件跟 Servlet 规范中的 ServletContext 接口有什么区别?跟 Spring 中的 ApplicationContext 又有什么关系?
| 组件 | 作用 | 生命周期 | 主要管理内容 | 关键方法 |
|---|---|---|---|---|
**Tomcat ****Context** | 表示一个 Web 应用 | 服务器启动时创建 | 负责 Servlet、Filter、Listener | addServlet(), getServletContext() |
**Servlet 规范 ****ServletContext** | Web 应用的全局上下文 | Web 应用启动时创建 | 共享资源、全局参数 | getAttribute(), getResourceAsStream() |
**Spring ****ApplicationContext** | Spring 容器的上下文 | Spring 容器启动时创建 | 依赖注入、Bean 管理 | getBean(), publishEvent() |
tomcat 跑起来之后会发生什么
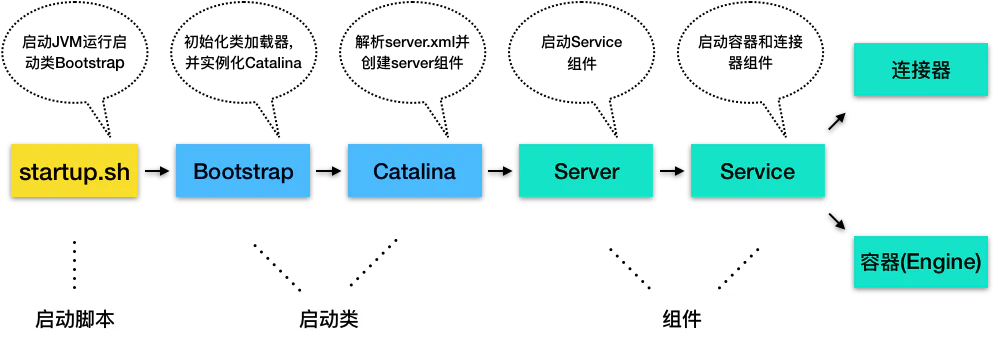
- Tomcat 本质上是一个 Java 程序,因此 startup.sh 脚本会启动一个 JVM 来运行 Tomcat 的启动类 Bootstrap。
- Bootstrap 的主要任务是初始化 Tomcat 的类加载器,并且创建 Catalina。关于 Tomcat 为什么需要自己的类加载器,我会在专栏后面详细介绍。
- Catalina 是一个启动类,它通过解析 server.xml、创建相应的组件,并调用 Server 的 start 方法。
- Server 组件的职责就是管理 Service 组件,它会负责调用 Service 的 start 方法。
- Service 组件的职责就是管理连接器和顶层容器 Engine,因此它会调用连接器和 Engine 的 start 方法。
Catalina
Catalina 的主要任务就是创建 Server,它不是直接 new 一个 Server 实例就完事了,而是需要解析 server.xml,把在 server.xml 里配置的各种组件一一创建出来,接着调用 Server 组件的 init 方法和 start 方法,这样整个 Tomcat 就启动起来了。作为“管理者”,Catalina 还需要处理各种“异常”情况,比如当我们通过“Ctrl + C”关闭 Tomcat 时,Tomcat 将如何优雅的停止并且清理资源呢?因此 Catalina 在 JVM 中注册一个“关闭钩子”。
public void start() {
    //1. 如果持有的 Server 实例为空,就解析 server.xml 创建出来
    if (getServer() == null) {
        load();
    }
    //2. 如果创建失败,报错退出
    if (getServer() == null) {
        log.fatal(sm.getString("catalina.noServer"));
        return;
    }

    //3. 启动 Server
    try {
        getServer().start();
    } catch (LifecycleException e) {
        return;
    }

    // 创建并注册关闭钩子
    if (useShutdownHook) {
        if (shutdownHook == null) {
            shutdownHook = new CatalinaShutdownHook();
        }
        Runtime.getRuntime().addShutdownHook(shutdownHook);
    }

    // 用 await 方法监听停止请求
    if (await) {
        await();
        stop();
    }
}
那什么是“关闭钩子”,它又是做什么的呢?如果我们需要在 JVM 关闭时做一些清理工作,比如将缓存数据刷到磁盘上,或者清理一些临时文件,可以向 JVM 注册一个“关闭钩子”。“关闭钩子”其实就是一个线程,JVM 在停止之前会尝试执行这个线程的 run 方法。下面我们来看看 Tomcat 的“关闭钩子”CatalinaShutdownHook 做了些什么。
protected class CatalinaShutdownHook extends Thread {

    @Override
    public void run() {
        try {
            if (getServer() != null) {
                Catalina.this.stop();
            }
        } catch (Throwable ex) {
           ...
        }
    }
}
从这段代码中你可以看到,Tomcat 的“关闭钩子”实际上就执行了 Server 的 stop 方法,Server 的 stop 方法会释放和清理所有的资源。
Server 组件
Server 组件的具体实现类是 StandardServer,我们来看下 StandardServer 具体实现了哪些功能。Server 继承了 LifeCycleBase,它的生命周期被统一管理,并且它的子组件是 Service,因此它还需要管理 Service 的生命周期,也就是说在启动时调用 Service 组件的启动方法,在停止时调用它们的停止方法。Server 在内部维护了若干 Service 组件,它是以数组来保存的,那 Server 是如何添加一个 Service 到数组中的呢?
@Override
public void addService(Service service) {

    service.setServer(this);

    synchronized (servicesLock) {
        // 创建一个长度 +1 的新数组
        Service results[] = new Service[services.length + 1];

        // 将老的数据复制过去
        System.arraycopy(services, 0, results, 0, services.length);
        results[services.length] = service;
        services = results;

        // 启动 Service 组件
        if (getState().isAvailable()) {
            try {
                service.start();
            } catch (LifecycleException e) {
                // Ignore
            }
        }

        // 触发监听事件
        support.firePropertyChange("service", null, service);
    }

}
从上面的代码你能看到,它并没有一开始就分配一个很长的数组,而是在添加的过程中动态地扩展数组长度,当添加一个新的 Service 实例时,会创建一个新数组并把原来数组内容复制到新数组,这样做的目的其实是为了节省内存空间。
除此之外,Server 组件还有一个重要的任务是启动一个 Socket 来监听停止端口,这就是为什么你能通过 shutdown 命令来关闭 Tomcat。不知道你留意到没有,上面 Caralina 的启动方法的最后一行代码就是调用了 Server 的 await 方法。
在 await 方法里会创建一个 Socket 监听 8005 端口,并在一个死循环里接收 Socket 上的连接请求,如果有新的连接到来就建立连接,然后从 Socket 中读取数据;如果读到的数据是停止命令“SHUTDOWN”,就退出循环,进入 stop 流程。
service 组件
Service 组件的具体实现类是 StandardService,我们先来看看它的定义以及关键的成员变量。
public class StandardService extends LifecycleBase implements Service {
    // 名字
    private String name = null;

    //Server 实例
    private Server server = null;

    // 连接器数组
    protected Connector connectors[] = new Connector[0];
    private final Object connectorsLock = new Object();

    // 对应的 Engine 容器
    private Engine engine = null;

    // 映射器及其监听器
    protected final Mapper mapper = new Mapper();
    protected final MapperListener mapperListener = new MapperListener(this);
StandardService 继承了 LifecycleBase 抽象类,此外 StandardService 中还有一些我们熟悉的组件,比如 Server、Connector、Engine 和 Mapper。
那为什么还有一个 MapperListener?这是因为 Tomcat 支持热部署,当 Web 应用的部署发生变化时,Mapper 中的映射信息也要跟着变化,MapperListener 就是一个监听器,它监听容器的变化,并把信息更新到 Mapper 中,这是典型的观察者模式。
作为“管理”角色的组件,最重要的是维护其他组件的生命周期。此外在启动各种组件时,要注意它们的依赖关系,也就是说,要注意启动的顺序。我们来看看 Service 启动方法:
protected void startInternal() throws LifecycleException {

//1. 触发启动监听器
setState(LifecycleState.STARTING);

//2. 先启动 Engine,Engine 会启动它子容器
if (engine != null) {
    synchronized (engine) {
        engine.start();
    }
}

//3. 再启动 Mapper 监听器
mapperListener.start();

//4. 最后启动连接器,连接器会启动它子组件,比如 Endpoint
synchronized (connectorsLock) {
    for (Connector connector: connectors) {
        if (connector.getState() != LifecycleState.FAILED) {
            connector.start();
        }
    }
}
}
从启动方法可以看到,Service 先启动了 Engine 组件,再启动 Mapper 监听器,最后才是启动连接器。这很好理解,因为内层组件启动好了才能对外提供服务,才能启动外层的连接器组件。而 Mapper 也依赖容器组件,容器组件启动好了才能监听它们的变化,因此 Mapper 和 MapperListener 在容器组件之后启动。组件停止的顺序跟启动顺序正好相反的,也是基于它们的依赖关系。
Engine 组件
最后我们再来看看顶层的容器组件 Engine 具体是如何实现的。Engine 本质是一个容器,因此它继承了 ContainerBase 基类,并且实现了 Engine 接口。
public class StandardEngine extends ContainerBase implements Engine {
}
我们知道,Engine 的子容器是 Host,所以它持有了一个 Host 容器的数组,这些功能都被抽象到了 ContainerBase 中,ContainerBase 中有这样一个数据结构:
protected final HashMap<String, Container> children = new HashMap<>();
ContainerBase 用 HashMap 保存了它的子容器,并且 ContainerBase 还实现了子容器的“增删改查”,甚至连子组件的启动和停止都提供了默认实现,比如 ContainerBase 会用专门的线程池来启动子容器。
for (int i = 0; i < children.length; i++) {
   results.add(startStopExecutor.submit(new StartChild(children[i])));
}
所以 Engine 在启动 Host 子容器时就直接重用了这个方法。
那 Engine 自己做了什么呢?我们知道容器组件最重要的功能是处理请求,而 Engine 容器对请求的“处理”,其实就是把请求转发给某一个 Host 子容器来处理,具体是通过 Valve 来实现的。
通过前面的学习,我们知道每一个容器组件都有一个 Pipeline,而 Pipeline 中有一个基础阀(Basic Valve),而 Engine 容器的基础阀定义如下:
final class StandardEngineValve extends ValveBase {

    public final void invoke(Request request, Response response)
      throws IOException, ServletException {

      // 拿到请求中的 Host 容器
      Host host = request.getHost();
      if (host == null) {
          return;
      }

      // 调用 Host 容器中的 Pipeline 中的第一个 Valve
      host.getPipeline().getFirst().invoke(request, response);
  }

}
这个基础阀实现非常简单,就是把请求转发到 Host 容器。你可能好奇,从代码中可以看到,处理请求的 Host 容器对象是从请求中拿到的,请求对象中怎么会有 Host 容器呢?这是因为请求到达 Engine 容器中之前,Mapper 组件已经对请求进行了路由处理,Mapper 组件通过请求的 URL 定位了相应的容器,并且把容器对象保存到了请求对象中。
总结一下
今天我们学习了 Tomcat 启动过程,具体是由启动类和“高层”组件来完成的,它们都承担着“管理”的角色,负责将子组件创建出来,并把它们拼装在一起,同时也掌握子组件的“生杀大权”。
所以当我们在设计这样的组件时,需要考虑两个方面:
首先要选用合适的数据结构来保存子组件,比如 Server 用数组来保存 Service 组件,并且采取动态扩容的方式,这是因为数组结构简单,占用内存小;再比如 ContainerBase 用 HashMap 来保存子容器,虽然 Map 占用内存会多一点,但是可以通过 Map 来快速的查找子容器。因此在实际的工作中,我们也需要根据具体的场景和需求来选用合适的数据结构。
其次还需要根据子组件依赖关系来决定它们的启动和停止顺序,以及如何优雅的停止,防止异常情况下的资源泄漏。这正是“管理者”应该考虑的事情。
不错的问题
- Server 组件的在启动连接器和容器时,都分别加了锁,这是为什么呢?
当然是因为用了线程不安全的数据结构
- tomcat 生产环境的线程数大小建议怎么设置
理论上:
线程数=((线程阻塞时间 + 线程忙绿时间) / 线程忙碌时间) * cpu核数
如果线程始终不阻塞,一直忙碌,会一直占用一个CPU核,因此可以直接设置 线程数=CPU核数。
但是现实中线程可能会被阻塞,比如等待IO。因此根据上面的公式确定线程数。
【非常重要】从Tomcat和Jetty中提炼组件化设计规范
那 Web 容器如何实现这种组件化设计呢?我认为有两个要点:
- 第一个是面向接口编程。我们需要对系统的功能按照“高内聚、低耦合”的原则进行拆分,每个组件都有相应的接口,组件之间通过接口通信,这样就可以方便地替换组件了。比如我们可以选择不同连接器类型,只要这些连接器组件实现同一个接口就行。
- 第二个是 Web 容器提供一个载体把组件组装在一起工作。组件的工作无非就是处理请求,因此容器通过责任链模式把请求依次交给组件去处理。对于用户来说,我只需要告诉 Web 容器由哪些组件来处理请求。把组件组织起来需要一个“管理者”,这就是为什么 Tomcat 和 Jetty 都有一个 Server 的概念,Server 就是组件的载体,Server 里包含了连接器组件和容器组件;容器还需要把请求交给各个子容器组件去处理,Tomcat 和 Jetty 都是责任链模式来实现的。
用户通过配置来组装组件,跟 Spring 中 Bean 的依赖注入相似。Spring 的用户可以通过配置文件或者注解的方式来组装 Bean,Bean 与 Bean 的依赖关系完全由用户自己来定义。这一点与 Web 容器不同,Web 容器中组件与组件之间的关系是固定的,比如 Tomcat 中 Engine 组件下有 Host 组件、Host 组件下有 Context 组件等,但你不能在 Host 组件里“注入”一个 Wrapper 组件,这是由于 Web 容器本身的功能来决定的。
组件的创建
由于组件是可以配置的,Web 容器在启动之前并不知道要创建哪些组件,也就是说,不能通过硬编码的方式来实例化这些组件,而是需要通过反射机制来动态地创建。具体来说,Web 容器不是通过 new 方法来实例化组件对象的,而是通过 Class.forName 来创建组件。无论哪种方式,在实例化一个类之前,Web 容器需要把组件类加载到 JVM,这就涉及一个类加载的问题,Web 容器设计了自己类加载器。
Spring 也是通过反射机制来动态地实例化 Bean,那么它用到的类加载器是从哪里来的呢?Web 容器给每个 Web 应用创建了一个类加载器,Spring 用到的类加载器是 Web 容器传给它的。
组件的生命周期管理
不同类型的组件具有父子层次关系,父组件处理请求后再把请求传递给某个子组件。而 Tomcat 通过容器的概念,把小容器放到大容器来实现父子关系,其实它们的本质都是一样的。这其实涉及如何统一管理这些组件,如何做到一键式启停。
Tomcat 和 Jetty 都采用了类似的办法来管理组件的生命周期,主要有两个要点,一是父组件负责子组件的创建、启停和销毁。这样只要启动最上层组件,整个 Web 容器就被启动起来了,也就实现了一键式启停;二是 Tomcat 和 Jetty 都定义了组件的生命周期状态,并且把组件状态的转变定义成一个事件,一个组件的状态变化会触发子组件的变化,比如 Host 容器的启动事件里会触发 Web 应用的扫描和加载,最终会在 Host 容器下创建相应的 Context 容器,而 Context 组件的启动事件又会触发 Servlet 的扫描,进而创建 Wrapper 组件。那么如何实现这种联动呢?答案是观察者模式。具体来说就是创建监听器去监听容器的状态变化,在监听器的方法里去实现相应的动作,这些监听器其实是组件生命周期过程中的“扩展点”。
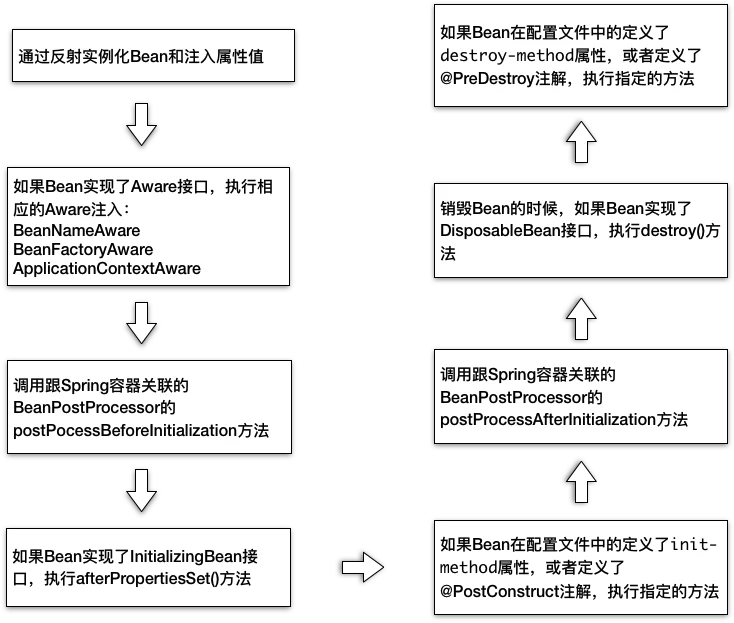
Spring 也采用了类似的设计,Spring 给 Bean 生命周期状态提供了很多的“扩展点”。这些扩展点被定义成一个个接口,只要你的 Bean 实现了这些接口,Spring 就会负责调用这些接口,这样做的目的就是,当 Bean 的创建、初始化和销毁这些控制权交给 Spring 后,Spring 让你有机会在 Bean 的整个生命周期中执行你的逻辑。下面我通过一张图帮你理解 Spring Bean 的生命周期过程:
组件的骨架抽象类和模板模式
具体到组件的设计的与实现,Tomcat 和 Jetty 都大量采用了骨架抽象类和模板模式。比如说 Tomcat 中 ProtocolHandler 接口,ProtocolHandler 有抽象基类 AbstractProtocol,它实现了协议处理层的骨架和通用逻辑,而具体协议也有抽象基类,比如 HttpProtocol 和 AjpProtocol。对于 Jetty 来说,Handler 接口之下有 AbstractHandler,Connector 接口之下有 AbstractorConnector,这些抽象骨架类实现了一些通用逻辑,并且会定义一些抽象方法,这些抽象方法由子类实现,抽象骨架类调用抽象方法来实现骨架逻辑。
这是一个通用的设计规范,不管是 Web 容器还是 Spring,甚至 JDK 本身都到处使用这种设计,比如 Java 集合中的 AbstractSet、AbstractMap 等。 值得一提的是,从 Java 8 开始允许接口有 default 方法,这样我们可以把抽象骨架类的通用逻辑放到接口中去。
优化并提高Tomcat启动速度(知道即可)
太细了,我没有看。
不过,我觉得我作为后端开发而言,对于 tomcat 的启动速度并不是太关系。
对于 spring boot 内嵌的 tomcat 而言,可以通过在Springboot里配置文章里提到的那些参数,比如:server.tomcat.additional-tld-skip-patterns: xxx*.jar或者通过TomcatServletWebServerFactory来修改参数
  @Bean
  public TomcatServletWebServerFactory tomcatFactory() {
    return new TomcatServletWebServerFactory() {
      @Override
      protected void postProcessContext(Context context) {
        ((StandardJarScanner) context.getJarScanner()).setScanManifest(false);
      }
    };
  }
4.tomcat中的池技术:线程池_对象池
Executor组件:Tomcat如何扩展Java线程池?
java 线程池
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory,
                          RejectedExecutionHandler handler)
每次提交任务时,如果线程数还没达到核心线程数corePoolSize,线程池就创建新线程来执行。当线程数达到corePoolSize后,新增的任务就放到工作队列workQueue里,而线程池中的线程则努力地从workQueue里拉活来干,也就是调用 poll 方法来获取任务。
如果任务很多,并且workQueue是个有界队列,队列可能会满,此时线程池就会紧急创建新的临时线程来救场,如果总的线程数达到了最大线程数maximumPoolSize,则不能再创建新的临时线程了,转而执行拒绝策略handler,比如抛出异常或者由调用者线程来执行任务等。
如果高峰过去了,线程池比较闲了怎么办?临时线程使用 poll(keepAliveTime, unit)方法从工作队列中拉活干,请注意 poll 方法设置了超时时间,如果超时了仍然两手空空没拉到活,表明它太闲了,这个线程会被销毁回收。
那还有一个参数threadFactory是用来做什么的呢?通过它你可以扩展原生的线程工厂,比如给创建出来的线程取个有意义的名字。
java 默认的线程池实现(不推荐)
public static ExecutorService newFixedThreadPool(int nThreads) {
    return new ThreadPoolExecutor(nThreads, nThreads,
                                  0L, TimeUnit.MILLISECONDS,
                                 new LinkedBlockingQueue<Runnable>());
}

public static ExecutorService newCachedThreadPool() {
    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                  60L, TimeUnit.SECONDS,
                                  new SynchronousQueue<Runnable>());
}
- FixedThreadPool 有固定长度(nThreads)的线程数组,忙不过来时会把任务放到无限长的队列里,这是因为LinkedBlockingQueue 默认是一个无界队列。
- CachedThreadPool 的 maximumPoolSize 参数值是
**<font style="color:rgb(53, 53, 53);">Integer.MAX_VALUE</font>**,因此它对线程个数不做限制,忙不过来时无限创建临时线程,闲下来时再回收。它的任务队列是SynchronousQueue,表明队列长度为 0。
Tomcat 线程池
跟 FixedThreadPool/CachedThreadPool 一样,Tomcat 的线程池也是一个定制版的 ThreadPoolExecutor。
通过比较 FixedThreadPool 和 CachedThreadPool,我们发现它们传给 ThreadPoolExecutor 的参数有两个关键点:
- 是否限制线程个数。
- 是否限制队列长度。
对于 Tomcat 来说,这两个资源都需要限制,也就是说要对高并发进行控制,否则 CPU 和内存有资源耗尽的风险。因此 Tomcat 传入的参数是这样的:
// 定制版的任务队列
taskqueue = new TaskQueue(maxQueueSize);

// 定制版的线程工厂
TaskThreadFactory tf = new TaskThreadFactory(namePrefix,daemon,getThreadPriority());

// 定制版的线程池
executor = new ThreadPoolExecutor(getMinSpareThreads(), getMaxThreads(), maxIdleTime, TimeUnit.MILLISECONDS,taskqueue, tf);
你可以看到其中的两个关键点:
- Tomcat 有自己的定制版任务队列和线程工厂,并且可以限制任务队列的长度,它的最大长度是 maxQueueSize。
- Tomcat 对线程数也有限制,设置了核心线程数(minSpareThreads)和最大线程池数(maxThreads)。
除了资源限制以外,Tomcat 线程池还定制自己的任务处理流程。我们知道 Java 原生线程池的任务处理逻辑比较简单:
- 前 corePoolSize 个任务时,来一个任务就创建一个新线程。
- 后面再来任务,就把任务添加到任务队列里让所有的线程去抢,如果队列满了就创建临时线程。
- 如果总线程数达到 maximumPoolSize,执行拒绝策略。
Tomcat 线程池扩展了原生的 ThreadPoolExecutor,通过重写 execute 方法实现了自己的任务处理逻辑:
- 前 corePoolSize 个任务时,来一个任务就创建一个新线程。
- 再来任务的话,就把任务添加到任务队列里让所有的线程去抢,如果队列满了就创建临时线程。
- 如果总线程数达到 maximumPoolSize,则继续尝试把任务添加到任务队列中去。
- 如果缓冲队列也满了,插入失败,执行拒绝策略。
观察 Tomcat 线程池和 Java 原生线程池的区别,其实就是在第 3 步,Tomcat 在线程总数达到最大数时,不是立即执行拒绝策略,而是再尝试向任务队列添加任务,添加失败后再执行拒绝策略。那具体如何实现呢,其实很简单,我们来看一下 Tomcat 线程池的 execute 方法的核心代码。
public class ThreadPoolExecutor extends java.util.concurrent.ThreadPoolExecutor {

  ...

  public void execute(Runnable command, long timeout, TimeUnit unit) {
      submittedCount.incrementAndGet();
      try {
          // 调用 Java 原生线程池的 execute 去执行任务
          super.execute(command);
      } catch (RejectedExecutionException rx) {
         // 如果总线程数达到 maximumPoolSize,Java 原生线程池执行拒绝策略
          if (super.getQueue() instanceof TaskQueue) {
              final TaskQueue queue = (TaskQueue)super.getQueue();
              try {
                  // 继续尝试把任务放到任务队列中去
                  if (!queue.force(command, timeout, unit)) {
                      submittedCount.decrementAndGet();
                      // 如果缓冲队列也满了,插入失败,执行拒绝策略。
                      throw new RejectedExecutionException("...");
                  }
              }
          }
      }
}
从这个方法你可以看到,Tomcat 线程池的 execute 方法会调用 Java 原生线程池的 execute 去执行任务,如果总线程数达到 maximumPoolSize,Java 原生线程池的 execute 方法会抛出 RejectedExecutionException 异常,但是这个异常会被 Tomcat 线程池的 execute 方法捕获到,并继续尝试把这个任务放到任务队列中去;如果任务队列也满了,再执行拒绝策略。
定制版的任务队列
细心的你有没有发现,在 Tomcat 线程池的 execute 方法最开始有这么一行:
submittedCount.incrementAndGet();
这行代码的意思把 submittedCount 这个原子变量加一,并且在任务执行失败,抛出拒绝异常时,将这个原子变量减一:
submittedCount.decrementAndGet();
其实 Tomcat 线程池是用这个变量 submittedCount 来维护已经提交到了线程池,但是还没有执行完的任务个数。Tomcat 为什么要维护这个变量呢?这跟 Tomcat 的定制版的任务队列有关。Tomcat 的任务队列 TaskQueue 扩展了 Java 中的 LinkedBlockingQueue,我们知道 LinkedBlockingQueue 默认情况下长度是没有限制的,除非给它一个 capacity。因此 Tomcat 给了它一个 capacity,TaskQueue 的构造函数中有个整型的参数 capacity,TaskQueue 将 capacity 传给父类 LinkedBlockingQueue 的构造函数。
public class TaskQueue extends LinkedBlockingQueue<Runnable> {

  public TaskQueue(int capacity) {
      super(capacity);
  }
  ...
}
这个 capacity 参数是通过 Tomcat 的 maxQueueSize 参数来设置的,但问题是默认情况下 maxQueueSize 的值是<font style="color:rgb(53, 53, 53);">Integer.MAX_VALUE</font>,等于没有限制,这样就带来一个问题:当前线程数达到核心线程数之后,再来任务的话线程池会把任务添加到任务队列,并且总是会成功,这样永远不会有机会创建新线程了。
为了解决这个问题,TaskQueue 重写了 LinkedBlockingQueue 的 offer 方法,在合适的时机返回 false,返回 false 表示任务添加失败,这时线程池会创建新的线程。那什么是合适的时机呢?请看下面 offer 方法的核心源码:
public class TaskQueue extends LinkedBlockingQueue<Runnable> {

  ...
   @Override
  // 线程池调用任务队列的方法时,当前线程数肯定已经大于核心线程数了
  public boolean offer(Runnable o) {

      // 如果线程数已经到了最大值,不能创建新线程了,只能把任务添加到任务队列。
      if (parent.getPoolSize() == parent.getMaximumPoolSize())
          return super.offer(o);

      // 执行到这里,表明当前线程数大于核心线程数,并且小于最大线程数。
      // 表明是可以创建新线程的,那到底要不要创建呢?分两种情况:

      //1. 如果已提交的任务数小于当前线程数,表示还有空闲线程,无需创建新线程
      if (parent.getSubmittedCount()<=(parent.getPoolSize()))
          return super.offer(o);

      //2. 如果已提交的任务数大于当前线程数,线程不够用了,返回 false 去创建新线程
      if (parent.getPoolSize()<parent.getMaximumPoolSize())
          return false;

      // 默认情况下总是把任务添加到任务队列
      return super.offer(o);
  }

}
从上面的代码我们看到,只有当前线程数大于核心线程数、小于最大线程数,并且已提交的任务个数大于当前线程数时,也就是说线程不够用了,但是线程数又没达到极限,才会去创建新的线程。这就是为什么 Tomcat 需要维护已提交任务数这个变量,它的目的就是在任务队列的长度无限制的情况下,让线程池有机会创建新的线程。
当然默认情况下 Tomcat 的任务队列是没有限制的,你可以通过设置 maxQueueSize 参数来限制任务队列的长度。
不错的问题
请你再仔细看看 Tomcat 的定制版任务队列 TaskQueue 的 offer 方法,它多次调用了 getPoolSize 方法,但是这个方法是有锁的,锁会引起线程上下文切换而损耗性能,请问这段代码可以如何优化呢?
- 直接读 work.size()即可,因为创建线程和销毁线程的方法都加锁了,而且是同一把锁。
- 所以,getPoolSize()方法不用额外加锁
对象池
Java 对象,特别是一个比较大、比较复杂的 Java 对象,它们的创建、初始化和 GC 都需要耗费 CPU 和内存资源,为了减少这些开销,Tomcat 和 Jetty 都使用了对象池技术。所谓的对象池技术,就是说一个 Java 对象用完之后把它保存起来,之后再拿出来重复使用,省去了对象创建、初始化和 GC 的过程。对象池技术是典型的以空间换时间的思路。
由于维护对象池本身也需要资源的开销,不是所有场景都适合用对象池。如果你的 Java 对象数量很多并且存在的时间比较短,对象本身又比较大比较复杂,对象初始化的成本比较高,这样的场景就适合用对象池技术。比如 Tomcat 和 Jetty 处理 HTTP 请求的场景就符合这个特征,请求的数量很多,为了处理单个请求需要创建不少的复杂对象(比如 Tomcat 连接器中 SocketWrapper 和 SocketProcessor),而且一般来说请求处理的时间比较短,一旦请求处理完毕,这些对象就需要被销毁,因此这个场景适合对象池技术。
Tomcat 的 SynchronizedStack
Tomcat 用 SynchronizedStack 类来实现对象池:
public class SynchronizedStack<T> {

    // 内部维护一个对象数组, 用数组实现栈的功能
    private Object[] stack;

    // 这个方法用来归还对象,用 synchronized 进行线程同步
    public synchronized boolean push(T obj) {
        index++;
        if (index == size) {
            if (limit == -1 || size < limit) {
                expand();// 对象不够用了,扩展对象数组
            } else {
                index--;
                return false;
            }
        }
        stack[index] = obj;
        return true;
    }

    // 这个方法用来获取对象
    public synchronized T pop() {
        if (index == -1) {
            return null;
        }
        T result = (T) stack[index];
        stack[index--] = null;
        return result;
    }

    // 扩展对象数组长度,以 2 倍大小扩展
    private void expand() {
      int newSize = size * 2;
      if (limit != -1 && newSize > limit) {
          newSize = limit;
      }
      // 扩展策略是创建一个数组长度为原来两倍的新数组
      Object[] newStack = new Object[newSize];
      // 将老数组对象引用复制到新数组
      System.arraycopy(stack, 0, newStack, 0, size);
      // 将 stack 指向新数组,老数组可以被 GC 掉了
      stack = newStack;
      size = newSize;
   }
}
这个代码逻辑比较清晰,主要是 SynchronizedStack 内部维护了一个对象数组,并且用数组来实现栈的接口:push 和 pop 方法,这两个方法分别用来归还对象和获取对象。你可能好奇为什么 Tomcat 使用一个看起来比较简单的 SynchronizedStack 来做对象容器,为什么不使用高级一点的并发容器比如 ConcurrentLinkedQueue 呢?
这是因为 SynchronizedStack 用数组而不是链表来维护对象,可以减少结点维护的内存开销,并且它本身只支持扩容不支持缩容,也就是说数组对象在使用过程中不会被重新赋值,也就不会被 GC。这样设计的目的是用最低的内存和 GC 的代价来实现无界容器,同时 Tomcat 的最大同时请求数是有限制的,因此不需要担心对象的数量会无限膨胀。
对象池的思考
对象池作为全局资源,高并发环境中多个线程可能同时需要获取对象池中的对象,因此多个线程在争抢对象时会因为锁竞争而阻塞, 因此使用对象池有线程同步的开销,而不使用对象池则有创建和销毁对象的开销。对于对象池本身的设计来说,需要尽量做到无锁化,比如 Jetty 就使用了 ConcurrentLinkedDeque。如果你的内存足够大,可以考虑用线程本地(ThreadLocal)对象池,这样每个线程都有自己的对象池,线程之间互不干扰。
为了防止对象池的无限膨胀,必须要对池的大小做限制。对象池太小发挥不了作用,对象池太大的话可能有空闲对象,这些空闲对象会一直占用内存,造成内存浪费。这里你需要根据实际情况做一个平衡,因此对象池本身除了应该有自动扩容的功能,还需要考虑自动缩容。
所有的池化技术,包括缓存,都会面临内存泄露的问题,原因是对象池或者缓存的本质是一个 Java 集合类,比如 List 和 Stack,这个集合类持有缓存对象的引用,只要集合类不被 GC,缓存对象也不会被 GC。维持大量的对象也比较占用内存空间,所以必要时我们需要主动清理这些对象。以 Java 的线程池 ThreadPoolExecutor 为例,它提供了 allowCoreThreadTimeOut 和 setKeepAliveTime 两种方法,可以在超时后销毁线程,我们在实际项目中也可以参考这个策略。
另外在使用对象池时,我这里还有一些小贴士供你参考:
- 对象在用完后,需要调用对象池的方法将对象归还给对象池。
- 对象池中的对象在再次使用时需要重置,否则会产生脏对象,脏对象可能持有上次使用的引用,导致内存泄漏等问题,并且如果脏对象下一次使用时没有被清理,程序在运行过程中会发生意想不到的问题。
- 对象一旦归还给对象池,使用者就不能对它做任何操作了。
- 向对象池请求对象时有可能出现的阻塞、异常或者返回 null 值,这些都需要我们做一些额外的处理,来确保程序的正常运行。
不错的问题
threadLocal中的对象如果用完不清。下次别的请求Tomcat线程池中拿到同个线程,能取到之前请求存入的数据么?
显然是会的,所以 threadLocal 要及时清理。
高效的并发编程
我们知道并发的过程中为了同步多个线程对共享变量的访问,需要加锁来实现。而锁的开销是比较大的,拿锁的过程本身就是个系统调用,如果锁没拿到线程会阻塞,又会发生线程上下文切换,尤其是大量线程同时竞争一把锁时,会浪费大量的系统资源。因此作为程序员,要有意识的尽量避免锁的使用,比如可以使用原子类 CAS 或者并发集合来代替。如果万不得已需要用到锁,也要尽量缩小锁的范围和锁的强度。接下来我们来看看 Tomcat 和 Jetty 如何做到高效的并发编程的。
缩小锁的范围
缩小锁的范围,其实就是不直接在方法上加 synchronized,而是使用细粒度的对象锁。
protected void startInternal() throws LifecycleException {
setState(LifecycleState.STARTING);
// 锁 engine 成员变量
if (engine != null) {
synchronized (engine) {
engine.start();
}
}
// 锁 executors 成员变量
synchronized (executors) {
for (Executor executor: executors) {
executor.start();
}
}
mapperListener.start();
// 锁 connectors 成员变量
synchronized (connectorsLock) {
for (Connector connector: connectors) {
// If it has already failed, don't try and start it
if (connector.getState() != LifecycleState.FAILED) {
connector.start();
}
}
}
}
复制代码
比如上面的代码是 Tomcat 的 StandardService 组件的启动方法,这个启动方法要启动三种子组件:engine、executors 和 connectors。它没有直接在方法上加锁,而是用了三把细粒度的锁,来分别用来锁三个成员变量。如果直接在方法上加 synchronized,多个线程执行到这个方法时需要排队;而在对象级别上加 synchronized,多个线程可以并行执行这个方法,只是在访问某个成员变量时才需要排队。
用原子变量和 CAS 取代锁
下面的代码是 Jetty 线程池的启动方法,它的主要功能就是根据传入的参数启动相应个数的线程。
private boolean startThreads(int threadsToStart)
{
while (threadsToStart > 0 && isRunning())
{
// 获取当前已经启动的线程数,如果已经够了就不需要启动了
int threads = _threadsStarted.get();
if (threads >= _maxThreads)
return false;
// 用 CAS 方法将线程数加一,请注意执行失败走 continue,继续尝试
if (!_threadsStarted.compareAndSet(threads, threads + 1))
continue;
boolean started = false;
try
{
Thread thread = newThread(_runnable);
thread.setDaemon(isDaemon());
thread.setPriority(getThreadsPriority());
thread.setName(_name + "-" + thread.getId());
_threads.add(thread);//_threads 并发集合
_lastShrink.set(System.nanoTime());//_lastShrink 是原子变量
thread.start();
started = true;
--threadsToStart;
}
finally
{
// 如果最终线程启动失败,还需要把线程数减一
if (!started)
_threadsStarted.decrementAndGet();
}
}
return true;
}
复制代码
你可以看到整个函数的实现是一个while 循环,并且是无锁的。<font style="color:rgb(53, 53, 53);">_threadsStarted</font>表示当前线程池已经启动了多少个线程,它是一个原子变量 AtomicInteger,首先通过它的 get 方法拿到值,如果线程数已经达到最大值,直接返回。否则尝试用 CAS 操作将<font style="color:rgb(53, 53, 53);">_threadsStarted</font>的值加一,如果成功了意味着没有其他线程在改这个值,当前线程可以继续往下执行;否则走 continue 分支,也就是继续重试,直到成功为止。在这里当然你也可以使用锁来实现,但是我们的目的是无锁化。
并发容器的使用
CopyOnWriteArrayList 适用于读多写少的场景,比如 Tomcat 用它来“存放”事件监听器,这是因为监听器一般在初始化过程中确定后就基本不会改变,当事件触发时需要遍历这个监听器列表,所以这个场景符合读多写少的特征。
public abstract class LifecycleBase implements Lifecycle {
// 事件监听器集合
private final List<LifecycleListener> lifecycleListeners = new CopyOnWriteArrayList<>();
...
}
复制代码
volatile 关键字的使用
再拿 Tomcat 中的 LifecycleBase 作为例子,它里面的生命状态就是用 volatile 关键字修饰的。volatile 的目的是为了保证一个线程修改了变量,另一个线程能够读到这种变化。对于生命状态来说,需要在各个线程中保持是最新的值,因此采用了 volatile 修饰。
public abstract class LifecycleBase implements Lifecycle {


    // 当前组件的生命状态,用 volatile 修饰

    private volatile LifecycleState state = LifecycleState.NEW;


}
不错的问题
| 类别 | 触发 **syscall**的 Java API |
|---|---|
| I/O 相关 | FileInputStream.read(), Socket.read() |
| 线程/进程 | Thread.sleep(), Thread.yield(), Runtime.exec() |
| 内存管理 | Unsafe.allocateMemory(), MappedByteBuffer.force() |
| 时间管理 | System.currentTimeMillis(), System.nanoTime() |
| 环境变量 | System.getenv(), System.getProperty() |
怎么减少系统调用?
✅ 使用用户态缓存
- **缓存 **
**System.currentTimeMillis()**,避免频繁调用(适用于高并发场景)。 - **使用
**ThreadLocal**或 ****FastThreadLocal**,减少线程切换时的内存访问。
✅ 避免不必要的 I/O
- 文件 I/O
- 使用
**BufferedInputStream**** / ****BufferedOutputStream**,减少read()/write()触发的syscall。 - 使用
**FileChannel**** + ****MappedByteBuffer**进行大文件读取,减少read()触发的syscall。
- 使用
- 网络 I/O
- 使用 NIO / Netty,减少阻塞式
read()/write()。 - 连接池(例如
HttpClient连接池)减少connect()触发的syscall。
- 使用 NIO / Netty,减少阻塞式
✅ 避免不必要的线程切换
- 避免
**Thread.sleep()**频繁调用(导致syscall)。 - **尽量使用
**CompletableFuture**或者 ****ForkJoinPool**,减少线程切换。 - **使用
**LockSupport.parkNanos()**代替 ****Thread.sleep()**(减少 CPU 资源浪费)。
在书架中单独阅读「4.tomcat中的池技术:线程池_对象池」→
5.spring-boot如何处理tomcat
为了方便开发和部署,Spring Boot 在内部启动了一个嵌入式的 Web 容器。我们知道 Tomcat 和 Jetty 是组件化的设计,要启动 Tomcat 或者 Jetty 其实就是启动这些组件。在 Tomcat 独立部署的模式下,我们通过 startup 脚本来启动 Tomcat,Tomcat 中的 Bootstrap 和 Catalina 会负责初始化类加载器,并解析<font style="color:rgb(53, 53, 53);">server.xml</font>和启动这些组件。
在内嵌式的模式下,Bootstrap 和 Catalina 的工作就由 Spring Boot 来做了,Spring Boot 调用了 Tomcat 和 Jetty 的 API 来启动这些组件。那 Spring Boot 具体是怎么做的呢?而作为程序员,我们如何向 SpringBoot 中的 Tomcat 注册 Servlet 或者 Filter 呢?我们又如何定制内嵌式的 Tomcat?今天我们就来聊聊这些话题。
Spring Boot 中 Web 容器相关的接口
既然要支持多种 Web 容器,Spring Boot 对内嵌式 Web 容器进行了抽象,定义了WebServer接口:
public interface WebServer {

    void start() throws WebServerException;

    void stop() throws WebServerException;

    int getPort();

}
各种 Web 容器比如 Tomcat 和 Jetty 需要去实现这个接口。
Spring Boot 还定义了一个工厂ServletWebServerFactory来创建 Web 容器,返回的对象就是上面提到的 WebServer。
public interface ServletWebServerFactory {

    WebServer getWebServer(ServletContextInitializer... initializers);

}
可以看到 getWebServer 有个参数,类型是ServletContextInitializer。它表示 ServletContext 的初始化器,用于 ServletContext 中的一些配置:
public interface ServletContextInitializer {

    void onStartup(ServletContext servletContext) throws ServletException;

}
这里请注意,上面提到的 getWebServer 方法会调用 ServletContextInitializer 的 onStartup 方法,也就是说如果你想在 Servlet 容器启动时做一些事情,比如注册你自己的 Servlet,可以实现一个 ServletContextInitializer,在 Web 容器启动时,Spring Boot 会把所有实现了 ServletContextInitializer 接口的类收集起来,统一调它们的 onStartup 方法。
为了支持对内嵌式 Web 容器的定制化,Spring Boot 还定义了WebServerFactoryCustomizerBeanPostProcessor接口,它是一个 BeanPostProcessor,它在 postProcessBeforeInitialization 过程中去寻找 Spring 容器中 WebServerFactoryCustomizer
类型的 Bean,并依次调用 WebServerFactoryCustomizer
接口的 customize 方法做一些定制化。
public interface WebServerFactoryCustomizer<T extends WebServerFactory> {

    void customize(T factory);

}
内嵌式 Web 容器的创建和启动
铺垫了这些接口,我们再来看看 Spring Boot 是如何实例化和启动一个 Web 容器的。我们知道,Spring 的核心是一个 ApplicationContext,它的抽象实现类 AbstractApplicationContext
实现了著名的refresh方法,它用来新建或者刷新一个 ApplicationContext,在 refresh 方法中会调用 onRefresh 方法,AbstractApplicationContext 的子类可以重写这个方法 onRefresh 方法,来实现特定 Context 的刷新逻辑,因此 ServletWebServerApplicationContext 就是通过重写 onRefresh 方法来创建内嵌式的 Web 容器,具体创建过程是这样的:
@Override

protected void onRefresh() {

    super.onRefresh();

    try {

        // 重写 onRefresh 方法,调用 createWebServer 创建和启动 Tomcat

        createWebServer();

    }

    catch (Throwable ex) {

    }

}


//createWebServer 的具体实现

private void createWebServer() {

    // 这里 WebServer 是 Spring Boot 抽象出来的接口,具体实现类就是不同的 Web 容器

    WebServer webServer = this.webServer;

    ServletContext servletContext = this.getServletContext();


    // 如果 Web 容器还没创建

    if (webServer == null && servletContext == null) {

        // 通过 Web 容器工厂来创建

        ServletWebServerFactory factory = this.getWebServerFactory();

        // 注意传入了一个 "SelfInitializer"

        this.webServer = factory.getWebServer(new ServletContextInitializer[]{this.getSelfInitializer()});


    } else if (servletContext != null) {

        try {

            this.getSelfInitializer().onStartup(servletContext);

        } catch (ServletException var4) {

            ...

        }

    }


    this.initPropertySources();

}
再来看看 getWebSever 具体做了什么,以 Tomcat 为例,主要调用 Tomcat 的 API 去创建各种组件:
public WebServer getWebServer(ServletContextInitializer... initializers) {

    //1. 实例化一个 Tomcat,可以理解为 Server 组件。

    Tomcat tomcat = new Tomcat();


    //2. 创建一个临时目录

    File baseDir = this.baseDirectory != null ? this.baseDirectory : this.createTempDir("tomcat");

    tomcat.setBaseDir(baseDir.getAbsolutePath());


    //3. 初始化各种组件

    Connector connector = new Connector(this.protocol);

    tomcat.getService().addConnector(connector);

    this.customizeConnector(connector);

    tomcat.setConnector(connector);

    tomcat.getHost().setAutoDeploy(false);

    this.configureEngine(tomcat.getEngine());


    //4. 创建定制版的 "Context" 组件。

    this.prepareContext(tomcat.getHost(), initializers);

    return this.getTomcatWebServer(tomcat);

}
你可能好奇 prepareContext 方法是做什么的呢?这里的 Context 是指Tomcat 中的 Context 组件,为了方便控制 Context 组件的行为,Spring Boot 定义了自己的 TomcatEmbeddedContext,它扩展了 Tomcat 的 StandardContext:
class TomcatEmbeddedContext extends StandardContext {}
注册 Servlet 的三种方式
1. Servlet 注解
在 Spring Boot 启动类上加上 @ServletComponentScan 注解后,使用 @WebServlet、@WebFilter、@WebListener 标记的 Servlet、Filter、Listener 就可以自动注册到 Servlet 容器中,无需其他代码,我们通过下面的代码示例来理解一下。
@SpringBootApplication

@ServletComponentScan

public class xxxApplication

{}
@WebServlet("/hello")

public class HelloServlet extends HttpServlet {}
在 Web 应用的入口类上加上 @ServletComponentScan, 并且在 Servlet 类上加上 @WebServlet,这样 SpringBoot 会负责将 Servlet 注册到内嵌的 Tomcat 中。
2. ServletRegistrationBean
同时 Spring Boot 也提供了 ServletRegistrationBean、FilterRegistrationBean 和 ServletListenerRegistrationBean 这三个类分别用来注册 Servlet、Filter、Listener。假如要注册一个 Servlet,可以这样做:
@Bean

public ServletRegistrationBean servletRegistrationBean() {

    return new ServletRegistrationBean(new HelloServlet(),"/hello");

}
这段代码实现的方法返回一个 ServletRegistrationBean,并将它当作 Bean 注册到 Spring 中,因此你需要把这段代码放到 Spring Boot 自动扫描的目录中,或者放到 @Configuration 标识的类中。
3. 动态注册
你还可以创建一个类去实现前面提到的 ServletContextInitializer 接口,并把它注册为一个 Bean,Spring Boot 会负责调用这个接口的 onStartup 方法。
@Component

public class MyServletRegister implements ServletContextInitializer {


    @Override

    public void onStartup(ServletContext servletContext) {


        //Servlet 3.0 规范新的 API

        ServletRegistration myServlet = servletContext

        .addServlet("HelloServlet", HelloServlet.class);


        myServlet.addMapping("/hello");


        myServlet.setInitParameter("name", "Hello Servlet");

    }


}
这里请注意两点:
- ServletRegistrationBean 其实也是通过 ServletContextInitializer 来实现的,它实现了 ServletContextInitializer 接口。
- 注意到 onStartup 方法的参数是我们熟悉的 ServletContext,可以通过调用它的 addServlet 方法来动态注册新的 Servlet,这是 Servlet 3.0 以后才有的功能。
Web 容器的定制
我们再来考虑一个问题,那就是如何在 Spring Boot 中定制 Web 容器。在 Spring Boot 2.0 中,我们可以通过两种方式来定制 Web 容器。
第一种方式是通过通用的 Web 容器工厂 ConfigurableServletWebServerFactory,来定制一些 Web 容器通用的参数:
@Component

public class MyGeneralCustomizer implements

WebServerFactoryCustomizer<ConfigurableServletWebServerFactory> {


    public void customize(ConfigurableServletWebServerFactory factory) {

        factory.setPort(8081);

        factory.setContextPath("/hello");

    }

}
第二种方式是通过特定 Web 容器的工厂比如 TomcatServletWebServerFactory 来进一步定制。下面的例子里,我们给 Tomcat 增加一个 Valve,这个 Valve 的功能是向请求头里添加 traceid,用于分布式追踪。TraceValve 的定义如下:
class TraceValve extends ValveBase {

    @Override

    public void invoke(Request request, Response response) throws IOException, ServletException {


        request.getCoyoteRequest().getMimeHeaders().

        addValue("traceid").setString("1234xxxxabcd");


        Valve next = getNext();

        if (null == next) {

            return;

        }


        next.invoke(request, response);

    }


}
跟第一种方式类似,再添加一个定制器,代码如下:
@Component

public class MyTomcatCustomizer implements

WebServerFactoryCustomizer<TomcatServletWebServerFactory> {


    @Override

    public void customize(TomcatServletWebServerFactory factory) {

        factory.setPort(8081);

        factory.setContextPath("/hello");

        factory.addEngineValves(new TraceValve() );


    }

}
本期精华
今天我们学习了 Spring Boot 如何利用 Web 容器的 API 来启动 Web 容器、如何向 Web 容器注册 Servlet,以及如何定制化 Web 容器,除了给 Web 容器配置参数,还可以增加或者修改 Web 容器本身的组件。
问题
我在文章中提到,通过 ServletContextInitializer 接口可以向 Web 容器注册 Servlet,那 ServletContextInitializer 跟 Tomcat 中的 ServletContainerInitializer 有什么区别和联系呢?
在 Spring Boot 中,我们可以不手动注册 **Servlet**,直接使用 @Controller 或 @RestController 处理 HTTP 请求,而这些 Controller 本质上是Spring MVC 框架封装的 Servlet 机制。
解答
1. Tomcat 作为 Servlet 容器
Spring Boot 默认使用内嵌 Tomcat 作为 Web 容器,而 Tomcat 运行 Spring MVC 时,本质上还是依赖 Servlet 规范,即:
- Spring Boot 自动注册了
**DispatcherServlet**作为前端控制器(Front Controller)。 - 所有
**@Controller**方法的请求都会经过**DispatcherServlet**进行分发处理。
2. **DispatcherServlet** 如何代替原生 **Servlet**?
通常,在传统的 Java Web 项目中,我们需要手动注册 <font style="color:rgb(53, 53, 53);">Servlet</font>,例如:
@WebServlet("/hello")
public class MyServlet extends HttpServlet {
    @Override
    protected void doGet(HttpServletRequest req, HttpServletResponse resp) throws IOException {
        resp.getWriter().write("Hello Servlet");
    }
}
但在 Spring Boot 中,我们可以直接用 <font style="color:rgb(53, 53, 53);">@Controller</font> 代替 <font style="color:rgb(53, 53, 53);">Servlet</font>:
@RestController
public class MyController {
    @GetMapping("/hello")
    public String hello() {
        return "Hello Spring Boot";
    }
}
为什么 **@Controller** 可以代替 **Servlet**?
- **Spring Boot 启动时自动注册 **
**DispatcherServlet**<font style="color:rgb(53, 53, 53);">DispatcherServlet</font>本质上是一个特殊的 Servlet,用于接管所有请求,并交给 Spring MVC 处理。- 它是一个
**HttpServlet**** 的子类**,Spring Boot 启动时会自动创建并注册:
@Bean
public DispatcherServlet dispatcherServlet() {
    return new DispatcherServlet();
}
- **Spring Boot 默认将 **`**DispatcherServlet**`** 映射到 **`**/**`**(拦截所有请求)**<font style="color:rgb(53, 53, 53);">: </font>
@Bean
public ServletRegistrationBean<DispatcherServlet> dispatcherRegistration(DispatcherServlet servlet) {
    return new ServletRegistrationBean<>(servlet, "/");
}
- 所有
**@Controller**请求会被**DispatcherServlet**处理<font style="color:rgb(53, 53, 53);">DispatcherServlet</font>作为 前端控制器(Front Controller),会拦截所有请求,并根据 URL 映射到对应的<font style="color:rgb(53, 53, 53);">@Controller</font>方法:<font style="color:rgb(53, 53, 53);">/hello</font>→<font style="color:rgb(53, 53, 53);">@GetMapping("/hello")</font><font style="color:rgb(53, 53, 53);">/user/1</font>→<font style="color:rgb(53, 53, 53);">@GetMapping("/user/{id}")</font>
- 它的底层实现类似:
public class DispatcherServlet extends FrameworkServlet {
    protected void doService(HttpServletRequest request, HttpServletResponse response) {
        // 解析请求路径,匹配 Controller 方法
        HandlerMethod handler = handlerMapping.getHandler(request);
        handlerAdapter.handle(request, response, handler);
    }
}
**3. **@Controller** vs 传统 ****Servlet**
| 对比项 | **传统 ****Servlet** | **Spring Boot ****@Controller** |
|---|---|---|
| 注册方式 | 需要 <font style="color:rgb(53, 53, 53);">@WebServlet</font>或 <font style="color:rgb(53, 53, 53);">web.xml</font>配置 | Spring Boot 自动注册 <font style="color:rgb(53, 53, 53);">DispatcherServlet</font> |
| 请求分发 | 由 <font style="color:rgb(53, 53, 53);">HttpServlet</font>处理请求 | <font style="color:rgb(53, 53, 53);">DispatcherServlet</font>自动解析 <font style="color:rgb(53, 53, 53);">@RequestMapping</font> |
| 参数获取 | <font style="color:rgb(53, 53, 53);">request.getParameter("name")</font> | 方法参数自动解析,如 <font style="color:rgb(53, 53, 53);">@RequestParam("name") String name</font> |
| 返回值 | 需要 <font style="color:rgb(53, 53, 53);">response.getWriter().write("xxx")</font> | 直接返回 <font style="color:rgb(53, 53, 53);">String</font>或 <font style="color:rgb(53, 53, 53);">JSON</font>,Spring MVC 自动处理 |
| 扩展性 | 逻辑代码集中在 <font style="color:rgb(53, 53, 53);">doGet()</font> | 支持 <font style="color:rgb(53, 53, 53);">@GetMapping</font>、 <font style="color:rgb(53, 53, 53);">@PostMapping</font>,更清晰 |
4. 结论
- Spring Boot 不需要手动注册 Servlet,因为
**DispatcherServlet**** 自动注册**,它会拦截所有 HTTP 请求。 **@Controller**** 只是对 Servlet 进行了封装**,本质上<font style="color:rgb(53, 53, 53);">@Controller</font>处理请求的方式仍然依赖<font style="color:rgb(53, 53, 53);">Servlet</font>机制。- 好处:
- 代码更简洁,不需要手写
<font style="color:rgb(53, 53, 53);">Servlet</font>逻辑。 - 支持自动参数解析,不需要
<font style="color:rgb(53, 53, 53);">request.getParameter()</font>。 - 支持 JSON 直接返回,无需手动写
<font style="color:rgb(53, 53, 53);">response.getWriter()</font>。
- 代码更简洁,不需要手写
这样,Spring Boot 让 Web 开发变得更简单、更高效! 🚀
Spring Boot 之所以可以运行 @Controller 并处理 HTTP 请求,本质上仍然是依赖 Tomcat 提供的 Servlet 容器来运行 DispatcherServlet。它们的关系如下:
1. Tomcat 在 Spring Boot 中的作用
Spring Boot 默认使用内嵌 Tomcat 作为 Web 容器,而 Tomcat 是一个 Servlet 容器,用于管理和执行 Servlet 规范的应用。具体来说,它的作用是:
- 监听 HTTP 请求
- 启动 Tomcat 时,会监听指定的端口(默认
8080),并等待 HTTP 请求的到来。
- 启动 Tomcat 时,会监听指定的端口(默认
- **创建
**HttpServletRequest**和 ****HttpServletResponse**- 当请求到达时,Tomcat 解析 HTTP 协议,封装成
HttpServletRequest(请求对象)和HttpServletResponse(响应对象)。
- 当请求到达时,Tomcat 解析 HTTP 协议,封装成
- **调用 **
**DispatcherServlet**- Tomcat 发现
/hello这样的请求路径后,会调用 Spring Boot 自动注册的DispatcherServlet进行请求分发:
- Tomcat 发现
HttpServletRequest request = new RequestFacade(req);
HttpServletResponse response = new ResponseFacade(resp);
dispatcherServlet.service(request, response);
- 最终返回响应
DispatcherServlet解析 URL,调用@Controller方法处理,并返回Response,然后 Tomcat 通过OutputStream返回 HTTP 响应给客户端。
2. Spring Boot 和 Tomcat 之间的关系
Spring Boot 的 spring-boot-starter-web 默认使用 **Tomcat** 作为内嵌 Web 容器:
- 这意味着 Spring Boot 项目不需要手动安装 Tomcat,它会在启动时自动创建一个 Tomcat 服务器。
- 运行
SpringApplication.run()时,Spring Boot 启动并初始化 Tomcat:
// Spring Boot 启动 Tomcat
TomcatWebServer webServer = new TomcatWebServer();
webServer.start(); // 监听 8080 端口
整个流程如下:
- 启动 Spring Boot(
SpringApplication.run()) - 初始化 Tomcat
- 注册
**DispatcherServlet**到 Tomcat - Tomcat 监听 HTTP 请求
- 请求到达 Tomcat,交给
**DispatcherServlet**处理 **DispatcherServlet**** 调用**@Controller**处理请求**- Tomcat 通过
**OutputStream**返回 HTTP 响应
3. Tomcat、Servlet、Spring Boot、Spring MVC 的关系
可以用一张图来表示:
+----------------------------+
|        浏览器请求          |
+----------------------------+
           │
           ▼
+----------------------------+
|        Tomcat 服务器       |   ⬅ (Servlet 容器)
+----------------------------+
           │
           ▼
+----------------------------+
|    DispatcherServlet (前端控制器) |
+----------------------------+
           │
           ▼
+----------------------------+
|     @Controller 业务逻辑   |
+----------------------------+
           │
           ▼
+----------------------------+
|   返回数据 (HTML / JSON)   |
+----------------------------+
- Tomcat:作为 Servlet 容器,接收 HTTP 请求,并调用
DispatcherServlet。 - DispatcherServlet:Spring MVC 核心,拦截所有请求,并转发到
@Controller处理。 - @Controller:开发者定义的业务逻辑,返回数据(HTML 或 JSON)。
- 最终:Tomcat 负责将返回数据通过 HTTP 传输回浏览器。
4. 为什么不直接使用 Tomcat?
在传统 Java Web 开发中,我们需要:
- 手动安装 Tomcat
- 手动部署 WAR 文件
- 手动配置 Servlet
但 Spring Boot 内嵌了 Tomcat,使得: ✅ 不用手动安装 Tomcat,直接运行 main() 方法即可启动
✅ 不用部署 WAR,直接 java -jar 运行 Spring Boot 应用
✅ **Spring Boot 负责自动注册 ****Servlet**,简化开发流程
5. 如何替换 Tomcat?
虽然 Spring Boot 默认使用 Tomcat,但我们可以替换成 Jetty 或 Undertow:
<!-- 1. 排除 Tomcat -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
    <exclusions>
        <exclusion>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-tomcat</artifactId>
        </exclusion>
    </exclusions>
</dependency>

<!-- 2. 添加 Jetty -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-jetty</artifactId>
</dependency>
这样 Spring Boot 就会使用 Jetty,而不是 Tomcat。
6. 总结
- Tomcat 是 Servlet 容器,它负责解析 HTTP 请求,并调用
Servlet。 - Spring Boot 通过
**DispatcherServlet**代理**Servlet**处理逻辑,所以可以用@Controller代替传统Servlet。 - Tomcat 仍然在底层运行,它负责启动 Web 服务器,解析 HTTP 请求,然后把请求交给
DispatcherServlet。 - Spring Boot 内嵌 Tomcat,使得 Web 应用可以用
**java -jar**直接运行,不需要额外的 Tomcat 服务器。
所以,Spring Boot 并没有绕开 Tomcat,而是利用 Tomcat 运行 **DispatcherServlet**,最终用 **@Controller** 处理 HTTP 请求。🚀
你的总结已经很详细了,以下是进一步精炼的核心要点,方便快速理解:
1. ServletContextInitializer vs ServletContainerInitializer
- ServletContextInitializer(Spring 提供)
- 作用:用于 Spring Boot 自动注册 Servlet、Filter、Listener,无需手写
web.xml。 - 运行时机:Spring Boot 启动时被
SpringServletContainerInitializer调用。 - 使用方式:通常通过
@Bean或SpringApplication自动加载。
- 作用:用于 Spring Boot 自动注册 Servlet、Filter、Listener,无需手写
- ServletContainerInitializer(Servlet 规范提供)
- 作用:Tomcat 等 Web 容器初始化 Servlet 时执行,可以在
META-INF/services注册。 - 运行时机:Web 容器(如 Tomcat)启动时执行,扫描
@HandlesTypes注解的类。 - Spring Boot 适配方式:Spring 通过
SpringServletContainerInitializer作为适配器,将其转换为ServletContextInitializer机制。
- 作用:Tomcat 等 Web 容器初始化 Servlet 时执行,可以在
2. 为什么 @Controller 可以替代 Servlet?
Spring Boot 通过 **DispatcherServlet** 代理了原生 Servlet 逻辑:
- **Spring Boot 启动时自动注册 **
**DispatcherServlet**DispatcherServlet继承自HttpServlet,是一个特殊的 Servlet。- 被映射到
/,拦截所有请求并交给 Spring MVC 处理。
- 请求流程
- Tomcat 监听 HTTP 请求,将其交给
DispatcherServlet。 DispatcherServlet解析 URL,匹配到@Controller方法并执行。- 结果返回给 Tomcat,最终响应给客户端。
- Tomcat 监听 HTTP 请求,将其交给
3. Spring Boot、Tomcat、Spring MVC 关系
- Tomcat:作为 Servlet 容器,解析 HTTP 请求,调用
DispatcherServlet处理。 - DispatcherServlet:Spring MVC 核心,拦截请求,调用
@Controller业务逻辑。 - @Controller:用户编写的业务逻辑层,返回 HTML/JSON 作为响应。
请求处理流程
- 客户端请求(浏览器访问
http://localhost:8080/hello)。 - Tomcat 解析 HTTP 请求,创建
HttpServletRequest和HttpServletResponse。 - **Tomcat 将请求转交给 **
**DispatcherServlet**进行处理。 **DispatcherServlet**** 解析 URL,匹配对应的**@Controller**方法**:
@RestController
public class MyController {
    @GetMapping("/hello")
    public String hello() {
        return "Hello Spring Boot";
    }
}
- 方法执行后返回数据,
DispatcherServlet处理响应,最终 Tomcat 发送回客户端。
4. Spring Boot 为什么比传统 Servlet 方便?
| 传统 Servlet | Spring Boot @Controller | |
|---|---|---|
| 注册方式 | @WebServlet或 web.xml | Spring Boot 自动注册 DispatcherServlet |
| 请求处理 | HttpServlet手动解析 request.getParameter() | @RequestParam自动解析参数 |
| 返回数据 | 需要 response.getWriter().write("xxx") | 直接返回 String或 JSON |
| 扩展性 | 逻辑集中在 doGet(),难维护 | 支持 @GetMapping,代码更清晰 |
Spring Boot 主要简化了 Servlet 开发:
- ✅ 不需要手动注册 Servlet,
DispatcherServlet自动代理。 - ✅ 简化参数解析,不用
request.getParameter()。 - ✅ 支持 JSON 响应,不用
response.getWriter()手动输出。
5. 如何替换 Tomcat?
虽然 Spring Boot 默认使用 Tomcat,但可以改为 Jetty 或 Undertow:
<!-- 移除 Tomcat -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
    <exclusions>
        <exclusion>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-tomcat</artifactId>
        </exclusion>
    </exclusions>
</dependency>

<!-- 添加 Jetty -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-jetty</artifactId>
</dependency>
这样 Spring Boot 就会使用 Jetty,而不是 Tomcat。
6. 总结
✅ Tomcat 是 Spring Boot 内嵌的 Servlet 容器,用于解析 HTTP 请求并调用 DispatcherServlet。
✅ Spring Boot 通过 **DispatcherServlet** 代理 Servlet 逻辑,让开发者可以直接用 @Controller 处理请求。
✅ Spring Boot 让 Web 开发更简洁高效,自动完成 Servlet 注册,支持参数解析和 JSON 响应。
✅ 可以替换 Tomcat 为 Jetty 或 Undertow,适配不同的 Web 服务器需求。
这样,Spring Boot 并没有绕开 Tomcat,而是利用 Tomcat 运行 **DispatcherServlet**,最终用 **@Controller** 处理 HTTP 请求。🚀
在书架中单独阅读「5.spring-boot如何处理tomcat」→