Java线程池深度解析
目标
深入理解Java线程池的底层实现原理、源码设计和最佳实践,掌握线程池的性能调优和问题排查方法。
核心架构
ThreadPoolExecutor整体架构
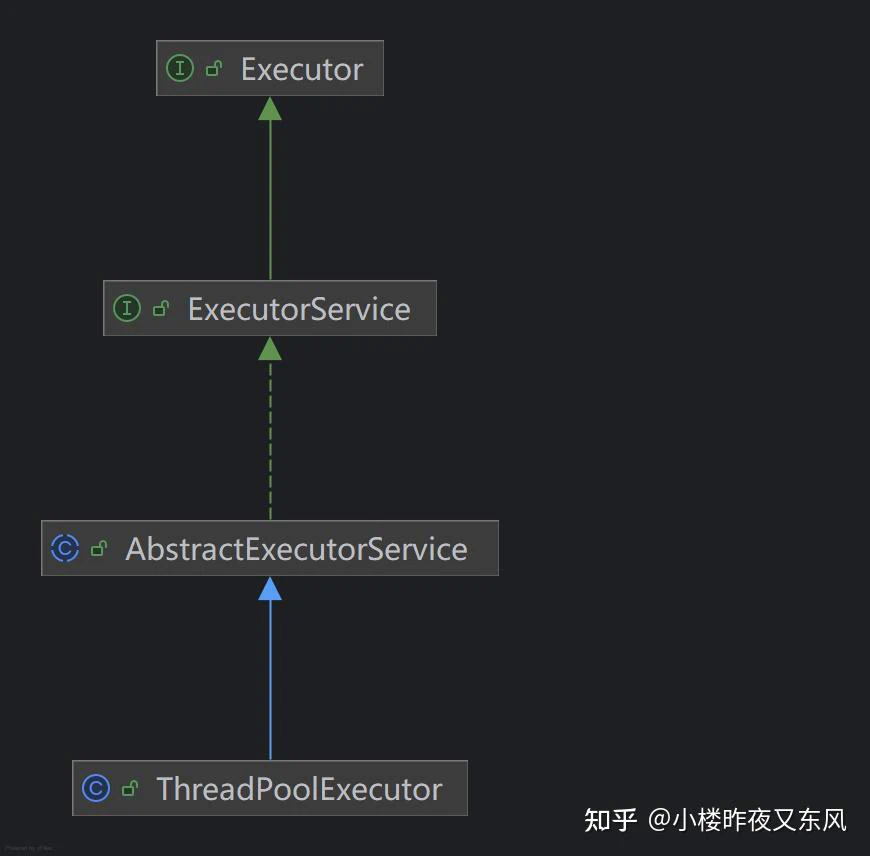
ThreadPoolExecutor是Java并发包中的核心组件,实现了ExecutorService接口,通过池化技术复用线程,避免频繁创建和销毁线程的开销。
线程池执行流程
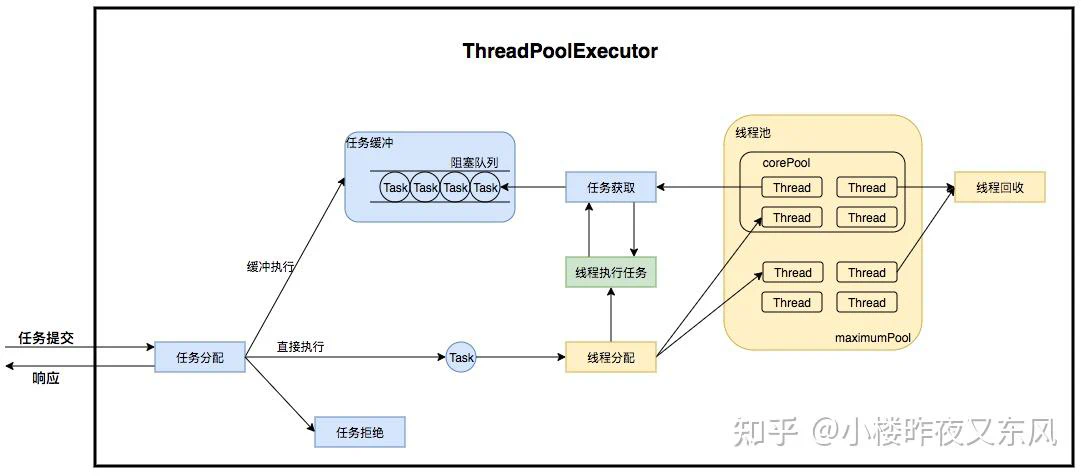
底层实现原理
1. 状态管理机制
线程池使用一个AtomicInteger类型的ctl变量同时维护两个关键信息:
- 运行状态(runState):高3位存储
- 工作线程数(workerCount):低29位存储
private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));
private static final int COUNT_BITS = Integer.SIZE - 3;
private static final int CAPACITY   = (1 << COUNT_BITS) - 1;

// 运行状态常量
private static final int RUNNING    = -1 << COUNT_BITS;  // 11100000000000000000000000000000
private static final int SHUTDOWN   =  0 << COUNT_BITS;  // 00000000000000000000000000000000
private static final int STOP       =  1 << COUNT_BITS;  // 00100000000000000000000000000000
private static final int TIDYING    =  2 << COUNT_BITS;  // 01000000000000000000000000000000
private static final int TERMINATED =  3 << COUNT_BITS;  // 01100000000000000000000000000000

// 位运算工具方法
private static int runStateOf(int c)     { return c & ~CAPACITY; }  // 获取运行状态
private static int workerCountOf(int c)  { return c & CAPACITY; }   // 获取工作线程数
private static int ctlOf(int rs, int wc) { return rs | wc; }        // 组合状态和线程数
设计优势:
- 原子性:使用
AtomicInteger保证状态更新的原子性 - 一致性:避免状态和线程数不一致的问题
- 性能:位运算比基本运算更快
- 空间效率:用一个变量存储两个值,节省内存
2. 线程生命周期管理
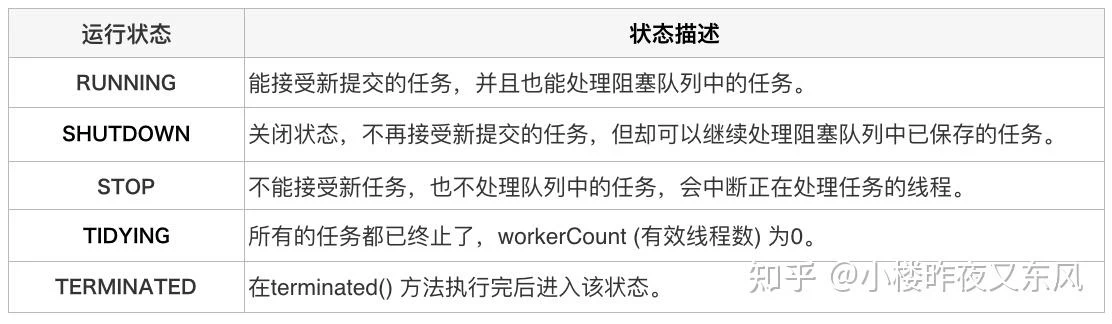
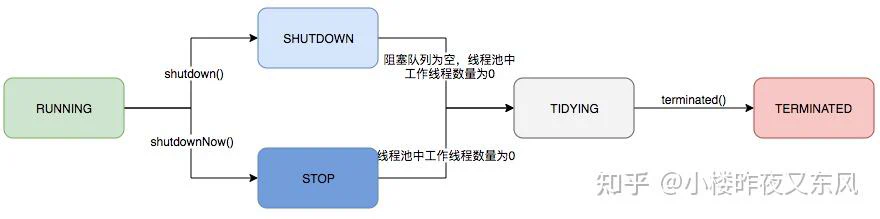
状态转换规则:
RUNNING → SHUTDOWN:调用shutdown()方法(RUNNING or SHUTDOWN) → STOP:调用shutdownNow()方法SHUTDOWN → TIDYING:队列和池都为空时STOP → TIDYING:池为空时TIDYING → TERMINATED:terminated()钩子方法完成
3. Worker线程实现
private final class Worker extends AbstractQueuedSynchronizer implements Runnable {
    final Thread thread;        // 工作线程
    Runnable firstTask;         // 第一个任务
    volatile long completedTasks; // 完成的任务数

    Worker(Runnable firstTask) {
        setState(-1); // 禁止中断,直到runWorker
        this.firstTask = firstTask;
        this.thread = getThreadFactory().newThread(this);
    }

    public void run() {
        runWorker(this);
    }

    // 锁相关方法
    protected boolean isHeldExclusively() {
        return getState() != 0;
    }

    protected boolean tryAcquire(int unused) {
        if (compareAndSetState(0, 1)) {
            setExclusiveOwnerThread(Thread.currentThread());
            return true;
        }
        return false;
    }

    protected boolean tryRelease(int unused) {
        setExclusiveOwnerThread(null);
        setState(0);
        return true;
    }
}
Worker设计特点:
- 继承AQS:实现可中断的锁机制
- 持有线程引用:便于管理和控制
- 记录任务数:用于统计和监控
核心执行流程
execute()方法源码分析
public void execute(Runnable command) {
    if (command == null)
        throw new NullPointerException();

    int c = ctl.get();

    // 1. 如果运行的线程少于corePoolSize,尝试添加核心线程
    if (workerCountOf(c) < corePoolSize) {
        if (addWorker(command, true))
            return;
        c = ctl.get();
    }

    // 2. 如果线程池正在运行,尝试将任务加入队列
    if (isRunning(c) && workQueue.offer(command)) {
        int recheck = ctl.get();
        // 双重检查:如果线程池已关闭,移除任务并拒绝
        if (!isRunning(recheck) && remove(command))
            reject(command);
        else if (workerCountOf(recheck) == 0)
            addWorker(null, false);
    }

    // 3. 如果无法加入队列,尝试创建非核心线程
    else if (!addWorker(command, false))
        reject(command);
}
执行策略:
- 核心线程优先:优先使用核心线程处理任务
- 队列缓冲:核心线程满时,任务进入队列
- 扩展线程:队列满时,创建非核心线程
- 拒绝策略:无法处理时,执行拒绝策略
addWorker()方法分析
private boolean addWorker(Runnable firstTask, boolean core) {
    retry:
    for (;;) {
        int c = ctl.get();
        int rs = runStateOf(c);

        // 检查线程池状态
        if (rs >= SHUTDOWN &&
            !(rs == SHUTDOWN && firstTask == null && !workQueue.isEmpty()))
            return false;

        for (;;) {
            int wc = workerCountOf(c);
            // 检查线程数限制
            if (wc >= CAPACITY ||
                wc >= (core ? corePoolSize : maximumPoolSize))
                return false;

            // CAS增加工作线程数
            if (compareAndIncrementWorkerCount(c))
                break retry;
            c = ctl.get();
            if (runStateOf(c) != rs)
                continue retry;
        }
    }

    boolean workerStarted = false;
    boolean workerAdded = false;
    Worker w = null;
    try {
        w = new Worker(firstTask);
        final Thread t = w.thread;
        if (t != null) {
            final ReentrantLock mainLock = this.mainLock;
            mainLock.lock();
            try {
                int rs = runStateOf(ctl.get());
                if (rs < SHUTDOWN ||
                    (rs == SHUTDOWN && firstTask == null)) {
                    if (t.isAlive())
                        throw new IllegalThreadStateException();
                    workers.add(w);
                    int s = workers.size();
                    if (s > largestPoolSize)
                        largestPoolSize = s;
                    workerAdded = true;
                }
            } finally {
                mainLock.unlock();
            }
            if (workerAdded) {
                t.start();
                workerStarted = true;
            }
        }
    } finally {
        if (!workerStarted)
            addWorkerFailed(w);
    }
    return workerStarted;
}
任务调度机制
任务获取策略
private Runnable getTask() {
    boolean timedOut = false;

    for (;;) {
        int c = ctl.get();
        int rs = runStateOf(c);

        // 检查线程池状态
        if (rs >= SHUTDOWN && (rs >= STOP || workQueue.isEmpty())) {
            decrementWorkerCount();
            return null;
        }

        int wc = workerCountOf(c);

        // 判断是否需要超时
        boolean timed = allowCoreThreadTimeOut || wc > corePoolSize;

        if ((wc > maximumPoolSize || (timed && timedOut))
            && (wc > 1 || workQueue.isEmpty())) {
            if (compareAndDecrementWorkerCount(c))
                return null;
            continue;
        }

        try {
            // 根据是否需要超时选择不同的获取方法
            Runnable r = timed ?
                workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) :
                workQueue.take();
            if (r != null)
                return r;
            timedOut = true;
        } catch (InterruptedException retry) {
            timedOut = false;
        }
    }
}
核心线程保活机制:
- 核心线程使用
workQueue.take()无限等待 - 非核心线程使用
workQueue.poll(timeout)超时等待 - 通过
allowCoreThreadTimeOut控制核心线程是否超时
队列实现原理
不同队列的性能特点
1. ArrayBlockingQueue
// 有界数组队列,使用ReentrantLock保证线程安全
public class ArrayBlockingQueue<E> extends AbstractQueue<E>
        implements BlockingQueue<E>, java.io.Serializable {

    final Object[] items;
    int takeIndex;
    int putIndex;
    int count;
    final ReentrantLock lock;
    private final Condition notEmpty;
    private final Condition notFull;
}
特点:基于数组实现的有界阻塞队列,内存连续且缓存友好,但使用单一锁导致锁竞争激烈,吞吐量相对较低,适合生产者-消费者模式。
2. LinkedBlockingQueue
// 无界链表队列,使用分离锁提高并发性
public class LinkedBlockingQueue<E> extends AbstractQueue<E>
        implements BlockingQueue<E>, java.io.Serializable {

    private final int capacity;
    private final AtomicInteger count = new AtomicInteger();
    transient Node<E> head;
    private transient Node<E> last;
    private final ReentrantLock takeLock = new ReentrantLock();
    private final Condition notEmpty = takeLock.newCondition();
    private final ReentrantLock putLock = new ReentrantLock();
    private final Condition notFull = putLock.newCondition();
}
特点:基于链表实现的无界阻塞队列,采用分离锁设计实现读写并发,吞吐量高但内存不连续,适合高并发场景。
3. SynchronousQueue
// 同步队列,直接交接,不存储元素
public class SynchronousQueue<E> extends AbstractQueue<E>
        implements BlockingQueue<E>, java.io.Serializable {

    private transient volatile Transferer<E> transferer;

    // 支持公平和非公平模式
    public SynchronousQueue(boolean fair) {
        transferer = fair ? new TransferQueue<E>() : new TransferStack<E>();
    }
}
特点:不存储元素的同步队列,采用无锁算法实现直接交接,性能极高但无缓冲能力,适合快速执行的任务。
拒绝策略深度分析
1. AbortPolicy(默认策略)
public static class AbortPolicy implements RejectedExecutionHandler {
    public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
        throw new RejectedExecutionException("Task " + r.toString() +
                                             " rejected from " +
                                             e.toString());
    }
}
适用场景:
- 对任务执行失败敏感的系统
- 需要快速发现问题的开发环境
- 有完善的异常处理机制
2. CallerRunsPolicy
public static class CallerRunsPolicy implements RejectedExecutionHandler {
    public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
        if (!e.isShutdown()) {
            r.run();  // 调用者线程执行任务
        }
    }
}
适用场景:
- 对任务执行时间不敏感
- 需要自动调节提交速度
- 防止系统过载
3. DiscardPolicy
public static class DiscardPolicy implements RejectedExecutionHandler {
    public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
        // 静默丢弃,不抛出异常
    }
}
适用场景:
- 对任务丢失不敏感
- 高吞吐量场景
- 实时性要求高的系统
4. DiscardOldestPolicy
public static class DiscardOldestPolicy implements RejectedExecutionHandler {
    public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
        if (!e.isShutdown()) {
            e.getQueue().poll();  // 丢弃最旧的任务
            e.execute(r);         // 执行新任务
        }
    }
}
适用场景:
- 新任务比旧任务重要
- 实时性要求高
- 可以容忍任务丢失
性能调优策略
1. 线程池大小优化
CPU密集型任务:
// 线程数 = CPU核心数 + 1
int cpuCount = Runtime.getRuntime().availableProcessors();
int corePoolSize = cpuCount + 1;
int maximumPoolSize = cpuCount * 2;
IO密集型任务:
// 线程数 = 根据qps来设立
int corePoolSize = ?;
int maximumPoolSize = ?;
混合型任务:
// 根据实际测试结果调整
int corePoolSize = ?
int maximumPoolSize = ?
2. 队列选择策略
高吞吐量场景:
// 使用无界队列,但要注意内存使用
new LinkedBlockingQueue<>()
内存敏感场景:
// 使用有界队列,防止OOM
new ArrayBlockingQueue<>(1000)
实时性要求高:
// 使用同步队列,直接交接
new SynchronousQueue<>()
3. 监控指标
// 关键监控指标
public class ThreadPoolMonitor {
    private ThreadPoolExecutor executor;

    public void printStats() {
        System.out.println("活跃线程数: " + executor.getActiveCount());
        System.out.println("核心线程数: " + executor.getCorePoolSize());
        System.out.println("最大线程数: " + executor.getMaximumPoolSize());
        System.out.println("当前线程数: " + executor.getPoolSize());
        System.out.println("已完成任务数: " + executor.getCompletedTaskCount());
        System.out.println("队列大小: " + executor.getQueue().size());
        System.out.println("队列剩余容量: " + executor.getQueue().remainingCapacity());
    }
}
常见问题与解决方案
1. 线程池过载问题
问题现象:
- 任务执行缓慢
- 系统响应延迟
- 内存使用过高
解决方案:
// 1. 调整线程池参数
ThreadPoolExecutor executor = new ThreadPoolExecutor(
    10, 20, 60L, TimeUnit.SECONDS,
    new ArrayBlockingQueue<>(1000),  // 有界队列
    new ThreadPoolExecutor.CallerRunsPolicy()  // 自动调节
);

// 2. 使用分布式线程池
// 3. 实现任务优先级
// 4. 添加监控告警
2. 内存泄漏问题
问题原因:
任务中持有大对象引用:任务执行过程中创建了大对象(如大数组、集合、文件流等),任务完成后这些对象仍然被线程池中的线程持有,无法被垃圾回收器回收。特别是在长时间运行的线程池中,这些对象会持续占用内存。
线程本地变量未清理:使用ThreadLocal存储数据时,如果任务完成后没有及时调用ThreadLocal.remove()方法清理,这些数据会一直存在于线程中,随着线程的复用而累积,最终导致内存泄漏。
队列中任务过多:当任务队列容量设置过大或使用无界队列时,大量任务在队列中等待执行,每个任务对象都会占用内存。如果任务提交速度远大于执行速度,队列中的任务会越来越多,最终导致内存溢出。
任务中创建子线程未正确管理:在任务中创建子线程但未正确设置线程的生命周期管理,子线程可能成为僵尸线程,占用系统资源。
回调函数或监听器未正确移除:任务中注册的回调函数、事件监听器等,如果任务完成后没有正确移除,会导致对象无法被回收。
具体场景示例:
// 场景1:任务中持有大对象引用
executor.execute(() -> {
    List<String> largeList = new ArrayList<>();
    // 加载大量数据到内存
    for (int i = 0; i < 1000000; i++) {
        largeList.add("data" + i);
    }
    processData(largeList);
    // 问题:largeList在任务完成后仍然被线程持有,无法被GC回收
});

// 场景2:ThreadLocal使用不当
ThreadLocal<byte[]> threadLocal = new ThreadLocal<>();
executor.execute(() -> {
    threadLocal.set(new byte[1024 * 1024]); // 1MB数据
    processData();
    // 问题:没有调用threadLocal.remove(),数据会一直存在
});

// 场景3:队列中任务过多
ThreadPoolExecutor executor = new ThreadPoolExecutor(
    2, 2, 0L, TimeUnit.MILLISECONDS,
    new LinkedBlockingQueue<>()  // 无界队列,可能导致OOM
);
解决方案:
// 1. 及时释放资源
executor.execute(() -> {
    try {
        // 执行业务逻辑
        processTask();
    } finally {
        // 清理资源
        cleanup();
    }
});

// 2. 使用弱引用
// 3. 定期清理队列
// 4. 设置合理的队列大小
3. 死锁问题
问题场景:
- 父子线程使用同一个线程池,但线程池核心线程数太少,阻塞队列也很小。具体表现为:父任务提交子任务到同一个线程池,当线程池核心线程数较少且队列容量有限时,父任务等待子任务完成,而子任务因线程池满载无法执行,形成死锁。
典型代码场景:
// 问题示例:父子任务使用同一线程池导致死锁
ThreadPoolExecutor executor = new ThreadPoolExecutor(
    2, 2, 0L, TimeUnit.MILLISECONDS,  // 核心线程数太少
    new ArrayBlockingQueue<>(2)       // 队列容量太小
);

// 父任务
executor.execute(() -> {
    System.out.println("父任务开始执行");

    // 提交多个子任务到同一个线程池
    for (int i = 0; i < 5; i++) {
        final int taskId = i;
        executor.execute(() -> {
            System.out.println("子任务 " + taskId + " 执行");
            // 子任务执行逻辑
        });
    }

    // 父任务等待所有子任务完成(这里会死锁)
    // 因为线程池已满,子任务无法执行,父任务永远等待
    System.out.println("父任务等待子任务完成");
});
解决方案:
// 1. 避免任务间依赖
// 2. 使用超时机制
Future<?> future = executor.submit(task);
try {
    future.get(5, TimeUnit.SECONDS);
} catch (TimeoutException e) {
    future.cancel(true);
}

// 3. 使用不同的线程池
// 4. 实现任务优先级
最佳实践总结
1. 线程池创建原则
- 使用
ThreadPoolExecutor构造函数,明确全部构造参数 - 明确指定所有参数
- 添加监控和告警机制
2. 参数配置原则
- 核心线程数:根据任务类型和CPU核心数设置
- 最大线程数:避免无限制创建线程
- 队列大小:根据内存和性能要求设置
- 拒绝策略:根据业务需求选择
3. 使用注意事项
- 及时释放任务中的资源
- 完善的任务异常处理机制
- 实时监控线程池状态
- 使用
shutdown()和awaitTermination()
4. 性能优化建议
- 根据场景选择合适的队列类型
- 通过压测确定最优线程数,动态调整
- 避免长时间阻塞的任务
- 不同业务使用不同的线程池