初识搜索
58同城站内搜索
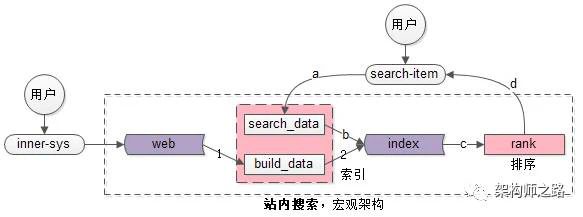
站内搜索是内部系统生成的数据,例如“发布系统”会将生成的帖子主动推给build_data系统
对于spider(全网)、search&index、rank三个系统: (1)spider(全网)和search&index是相对工程的系统 (2)rank是和业务、策略紧密、算法相关的系统,搜索体验的差异主要在此。
搜索原理与核心数据结构
正排索引可以理解为Map<url, list
倒排索引可以理解为Map<item, list
举个例子,假设有3个网页: url1 -> “我爱北京” url2 -> “我爱到家” url3 -> “到家美好” 这是一个正排索引Map<url, page_content>。
分词之后: url1 -> {我,爱,北京} url2 -> {我,爱,到家} url3 -> {到家,美好} 这是一个分词后的正排索引Map<url, list
- >。
分词后倒排索引: 我 -> {url1, url2} 爱 -> {url1, url2} 北京 -> {url1} 到家 -> {url2, url3} 美好 -> {url3}
由检索词item快速找到包含这个查询词的网页Map<item, list
>就是倒排索引。
搜索的过程是什么样的?
假设搜索词是“我爱”,用户会得到什么网页呢?
(1)分词,“我爱”会分词为{我,爱},时间复杂度为O(1)
(2)每个分词后的item,从倒排索引查询包含这个item的网页list
现在又出现一个问题怎么求url的交集?
- 暴力
- 双指针,找到相同的放进去(有序)
- 水平分桶+并发求交集 | 水平分桶+BitMap直接求交集
- 跳表,跳多少是一个比较有难度的操作(那为啥不直接二分?。。。)
实战之如何快速实现高并发短文检索
需求
某并发量很大,数据量适中的业务线需要实现一个“标题检索”的功能: (1)并发量较大,每秒20w次 (2)数据量适中,大概200w数据 (3)是否需要分词:是 (4)数据是否实时更新:否
个人理解
离线抽象某个数据结构并存在内存中。
要考虑实现分词,该需求的难点在某个数据结构上,要求实现倒排。
学习了下DAT,仅用两个数组表示一个trie,O(len),但维护起来很复杂,适合离线构建。
大佬的做法是Hash - Id,可以理解,Hash是为了构建DAT,将标题分词之后构建倒排,每次查询也是分词后,取出交集。
工程架构
- 离线部分:主要是内容理解工作,另外还有用户画像等工作,按需增加。
- Query理解:负责对用户query进行处理,并提取下游检索、排序所需要的信息。
- 检索召回:从数据库中快速找出合适的内容,并进行阶段。
- 排序:对内容进行精筛,找到最优的TOPN内容。
离线部分,即对各种来源进行处理,比如新开店铺、新开帖子,对其进行Qu、rank等一系列操作,这部分我的理解可以不实时更新,在业务压力不大的时候更新。或者通过主从分离,主写、从读,来达到实时的更新
QU部分,则是对于搜索的意图进行分析,用户是在搜索的时候,是想吃饭,还是健身房,还是看电影,然后根据给到的Qu,进行正式的推文。
检索召回,这部分页很关键,通过用户的搜索词以及Qu的理解,召回一堆数据,这部分的数据是比较符合用户意图的。
排序,对召回的数据进行筛选,找到最适合展示出来的TOPN,具体实现以及排序的各种阶段,需要看算法侧提供的能力,
参考
深入浅出搜索架构引擎、方案与细节(上) 深入浅出搜索系列之(一)- 初识搜索 深入浅出搜索原理系列之(二)查询构建 前沿重器[48] | 聊聊搜索系统1:开篇语 前沿重器[49] | 聊聊搜索系统2:常见架构