我们已经了解了 Tomcat 要实现 2 个核心功能:
- 处理 Socket 连接,负责网络字节流与 Request 和 Response 对象的转化。
- 加载和管理 Servlet,以及具体处理 Request 请求。
因此 Tomcat 设计了两个核心组件连接器(Connector)和容器(Container)来分别做这两件事情。连接器负责对外交流,容器负责内部处理。
连接器
Tomcat 支持多种 I/O 模型和应用层协议。
Tomcat 支持的 I/O 模型有:
- NIO:非阻塞 I/O,采用 Java NIO 类库实现。
- NIO2:异步 I/O,采用 JDK 7 最新的 NIO2 类库实现。
- APR:采用 Apache 可移植运行库实现,是 C/C++ 编写的本地库。
Tomcat 支持的应用层协议有:
- HTTP/1.1:这是大部分 Web 应用采用的访问协议。
- AJP:用于和 Web 服务器集成(如 Apache)。
- HTTP/2:HTTP 2.0 大幅度的提升了 Web 性能。
Tomcat 为了实现支持多种 I/O 模型和应用层协议,一个容器可能对接多个连接器,就好比一个房间有多个门。但是单独的连接器或者容器都不能对外提供服务,需要把它们组装起来才能工作,组装后这个整体叫作 Service 组件。这里请你注意,Service 本身没有做什么重要的事情,只是在连接器和容器外面多包了一层,把它们组装在一起。Tomcat 内可能有多个 Service,这样的设计也是出于灵活性的考虑。通过在 Tomcat 中配置多个 Service,可以实现通过不同的端口号来访问同一台机器上部署的不同应用。
到此我们得到这样一张关系图:
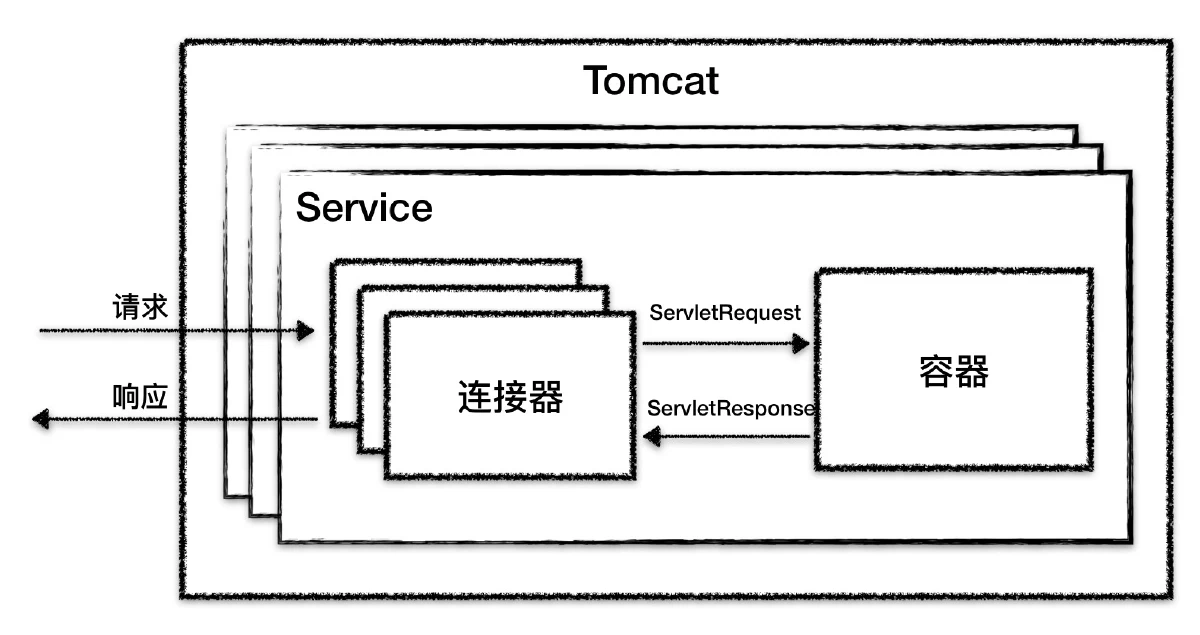
从图上你可以看到,最顶层是 Server,这里的 Server 指的就是一个 Tomcat 实例。一个 Server 中有一个或者多个 Service,一个 Service 中有多个连接器和一个容器。连接器与容器之间通过标准的 ServletRequest 和 ServletResponse 通信。
连接器对 Servlet 容器屏蔽了协议及 I/O 模型等的区别,无论是 HTTP 还是 AJP,在容器中获取到的都是一个标准的 ServletRequest 对象。
通过分析连接器的详细功能列表,我们发现连接器需要完成 3 个高内聚的功能:
- 网络通信。
- 应用层协议解析。
- Tomcat Request/Response 与 ServletRequest/ServletResponse 的转化。
因此 Tomcat 的设计者设计了 3 个组件来实现这 3 个功能,分别是 EndPoint、Processor 和 Adapter。
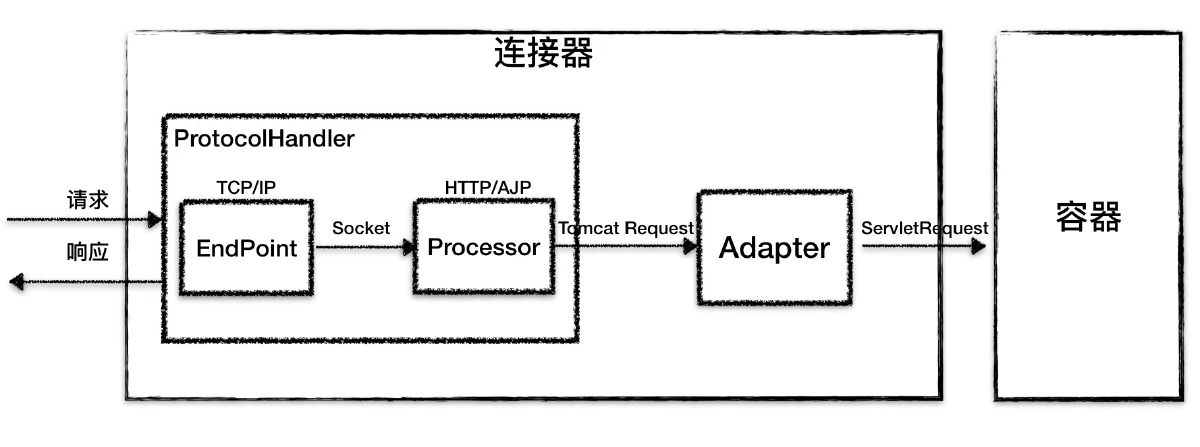
顶层组件有两个: ProtocolHandler 和 Adapter。
ProtocolHandler 组件
由上文我们知道,连接器用 ProtocolHandler 来处理网络连接和应用层协议,包含了 2 个重要部件:EndPoint 和 Processor。
EndPoint
EndPoint 是通信端点,即通信监听的接口,是具体的 Socket 接收和发送处理器,是对传输层的抽象,因此 EndPoint 是用来实现 TCP/IP 协议的。
EndPoint 是一个接口,对应的抽象实现类是 AbstractEndpoint,而 AbstractEndpoint 的具体子类,比如在 NioEndpoint 和 Nio2Endpoint 中,有两个重要的子组件:Acceptor 和 SocketProcessor。
其中 Acceptor 用于监听 Socket 连接请求。SocketProcessor 用于处理接收到的 Socket 请求,它实现 Runnable 接口,在 Run 方法里调用协议处理组件 Processor 进行处理。为了提高处理能力,SocketProcessor 被提交到线程池来执行。而这个线程池叫作执行器(Executor)。
Processor
如果说 EndPoint 是用来实现 TCP/IP 协议的,那么 Processor 用来实现 HTTP 协议,Processor 接收来自 EndPoint 的 Socket,读取字节流解析成 Tomcat Request 和 Response 对象,并通过 Adapter 将其提交到容器处理,Processor 是对应用层协议的抽象。
Processor 是一个接口,定义了请求的处理等方法。它的抽象实现类 AbstractProcessor 对一些协议共有的属性进行封装,没有对方法进行实现。具体的实现有 AJPProcessor、HTTP11Processor 等,这些具体实现类实现了特定协议的解析方法和请求处理方式。
我们再来看看连接器的组件图:
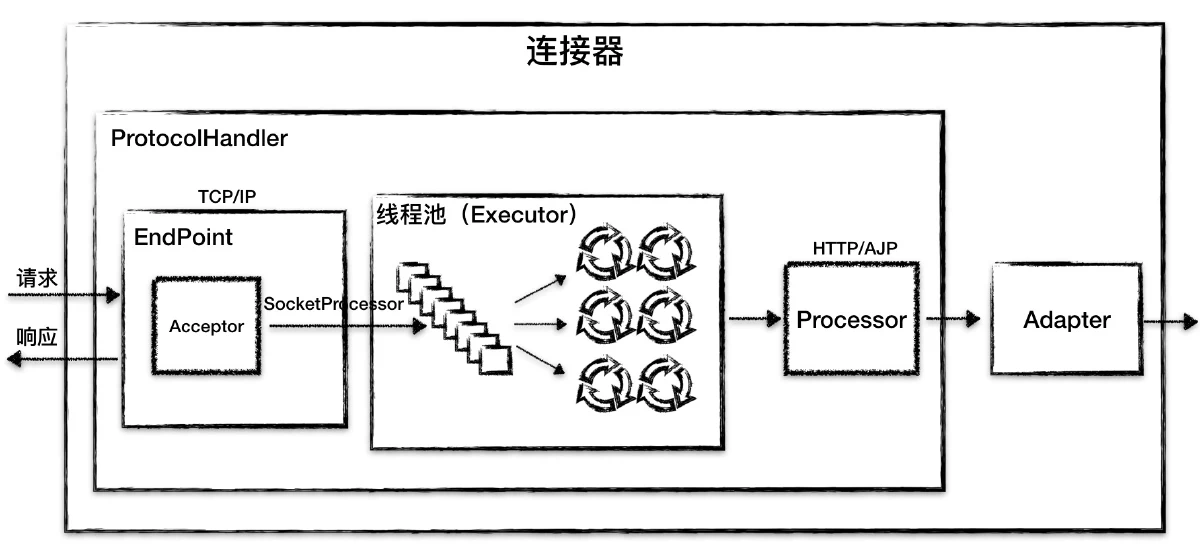
从图中我们看到,EndPoint 接收到 Socket 连接后,生成一个 SocketProcessor 任务提交到线程池去处理,SocketProcessor 的 Run 方法会调用 Processor 组件去解析应用层协议,Processor 通过解析生成 Request 对象后,会调用 Adapter 的 Service 方法。
Adapter 组件
我在前面说过,由于协议不同,客户端发过来的请求信息也不尽相同,Tomcat 定义了自己的 Request 类来“存放”这些请求信息。ProtocolHandler 接口负责解析请求并生成 Tomcat Request 类。但是这个 Request 对象不是标准的 ServletRequest,也就意味着,不能用 Tomcat Request 作为参数来调用容器。Tomcat 设计者的解决方案是引入 CoyoteAdapter,这是适配器模式的经典运用,连接器调用 CoyoteAdapter 的 Sevice 方法,传入的是 Tomcat Request 对象,CoyoteAdapter 负责将 Tomcat Request 转成 ServletRequest,再调用容器的 Service 方法。
总结一下
Tomcat 的整体架构包含了两个核心组件连接器和容器。连接器负责对外交流,容器负责内部处理。连接器用 ProtocolHandler 接口来封装通信协议和 I/O 模型的差异,ProtocolHandler 内部又分为 EndPoint 和 Processor 模块,EndPoint 负责底层 Socket 通信,Proccesor 负责应用层协议解析。连接器通过适配器 Adapter 调用容器。
不错的问题
- tomcat和netty有什么区别呢?为什么netty常常用做底层通讯模块,而tomcat作为web容器呢?
你可以把Netty理解成Tomcat中的连接器,它们都负责网络通信,都利用了Java NIO非阻塞特性。但Netty素以高性能高并发著称,为什么Tomcat不把连接器替换成Netty呢?第一个原因是Tomcat的连接器性能已经足够好了,同样是Java NIO编程,套路都差不多。第二个原因是Tomcat做为Web容器,需要考虑到Servlet规范,Servlet规范规定了对HTTP Body的读写是阻塞的,因此即使用到了Netty,也不能充分发挥它的优势。所以Netty一般用在非HTTP协议和Servlet的场景下。 - 请求来的时候,源码入口在哪里?
在Acceptor的run方法里:
socket = endpoint.serverSocketAccept();
这句话用来接收一个新的连接
容器
Tomcat 设计了 4 种容器,分别是 Engine、Host、Context 和 Wrapper。这 4 种容器不是平行关系,而是父子关系。下面我画了一张图帮你理解它们的关系。
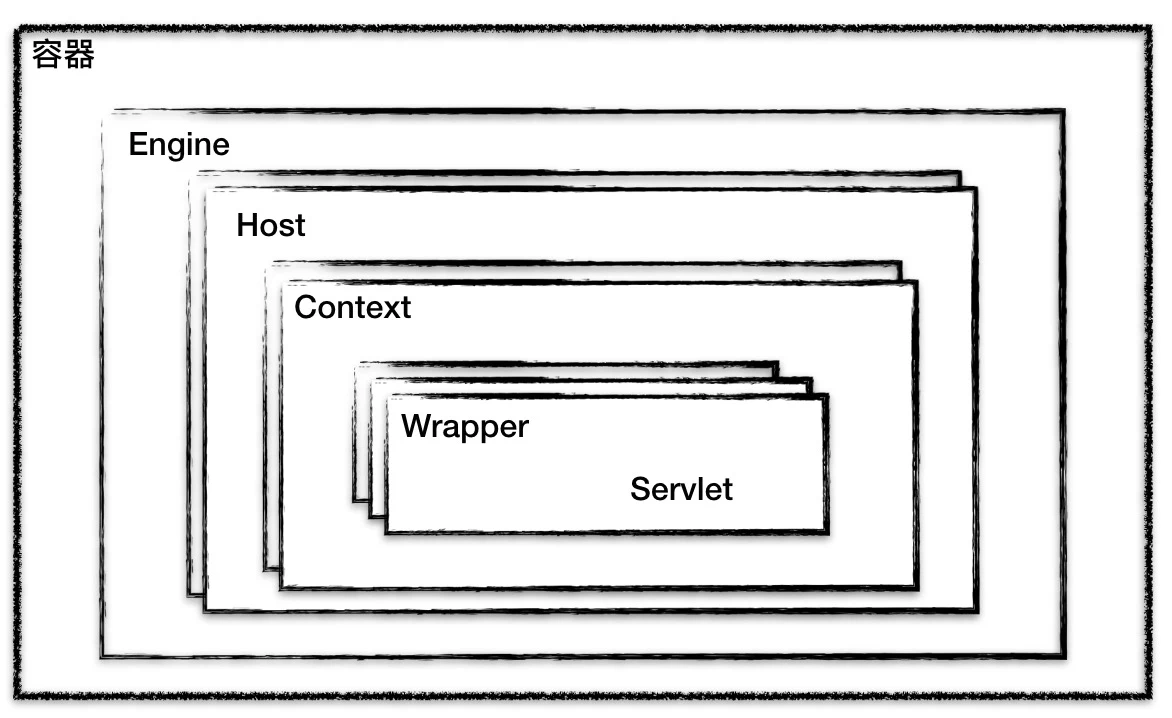
Tomcat 通过一种分层的架构,使得 Servlet 容器具有很好的灵活性。
Context 表示一个 Web 应用程序;Wrapper 表示一个 Servlet,一个 Web 应用程序中可能会有多个 Servlet;Host 代表的是一个虚拟主机,或者说一个站点,可以给 Tomcat 配置多个虚拟主机地址,而一个虚拟主机下可以部署多个 Web 应用程序;Engine 表示引擎,用来管理多个虚拟站点,一个 Service 最多只能有一个 Engine。
你可以再通过 Tomcat 的 server.xml 配置文件来加深对 Tomcat 容器的理解。Tomcat 采用了组件化的设计,它的构成组件都是可配置的,其中最外层的是 Server,其他组件按照一定的格式要求配置在这个顶层容器中。
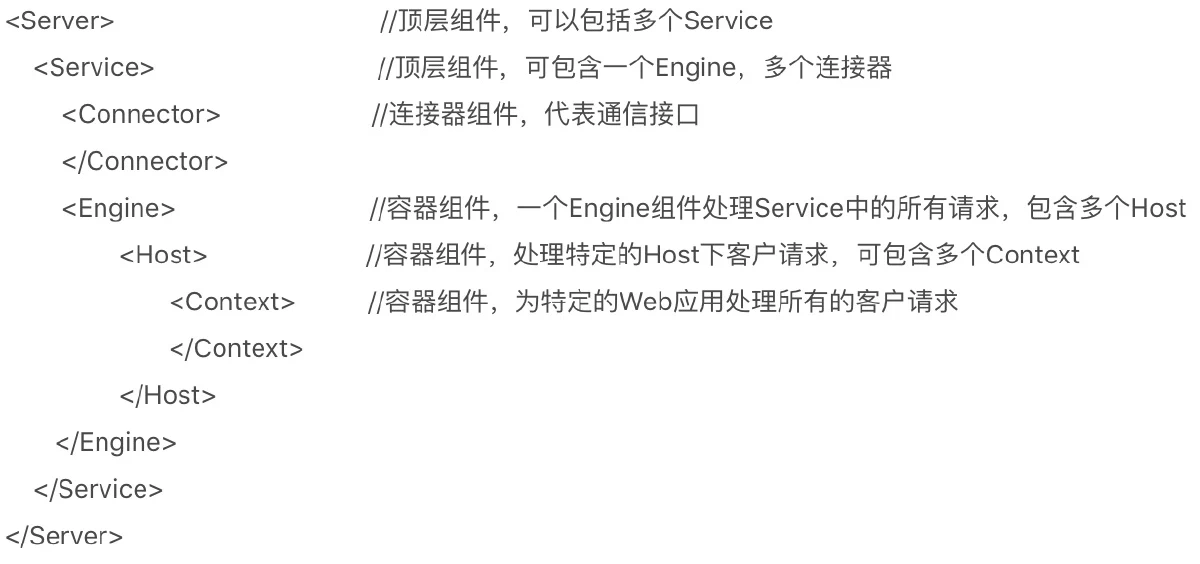
那么,Tomcat 是怎么管理这些容器的呢?你会发现这些容器具有父子关系,形成一个树形结构,你可能马上就想到了设计模式中的组合模式。没错,Tomcat 就是用组合模式来管理这些容器的。具体实现方法是,所有容器组件都实现了 Container 接口,因此组合模式可以使得用户对单容器对象和组合容器对象的使用具有一致性。这里单容器对象指的是最底层的 Wrapper,组合容器对象指的是上面的 Context、Host 或者 Engine。Container 接口定义如下:
public interface Container extends Lifecycle {
    public void setName(String name);
    public Container getParent();
    public void setParent(Container container);
    public void addChild(Container child);
    public void removeChild(Container child);
    public Container findChild(String name);
}
正如我们期望的那样,我们在上面的接口看到了 getParent、SetParent、addChild 和 removeChild 等方法。你可能还注意到 Container 接口扩展了 LifeCycle 接口,LifeCycle 接口用来统一管理各组件的生命周期,这里暂时不讲。
请求定位 Servlet 的过程
你可能好奇,设计了这么多层次的容器,Tomcat 是怎么确定请求是由哪个 Wrapper 容器里的 Servlet 来处理的呢?答案是,Tomcat 是用 Mapper 组件来完成这个任务的。
Mapper 组件的功能就是将用户请求的 URL 定位到一个 Servlet,它的工作原理是:Mapper 组件里保存了 Web 应用的配置信息,其实就是容器组件与访问路径的映射关系,比如 Host 容器里配置的域名、Context 容器里的 Web 应用路径,以及 Wrapper 容器里 Servlet 映射的路径,你可以想象这些配置信息就是一个多层次的 Map。
当一个请求到来时,Mapper 组件通过解析请求 URL 里的域名和路径,再到自己保存的 Map 里去查找,就能定位到一个 Servlet。请你注意,一个请求 URL 最后只会定位到一个 Wrapper 容器,也就是一个 Servlet。
读到这里你可能感到有些抽象,接下来我通过一个例子来解释这个定位的过程。
假如有一个网购系统,有面向网站管理人员的后台管理系统,还有面向终端客户的在线购物系统。这两个系统跑在同一个 Tomcat 上,为了隔离它们的访问域名,配置了两个虚拟域名:<font style="color:rgb(53, 53, 53);">manage.shopping.com</font>和<font style="color:rgb(53, 53, 53);">user.shopping.com</font>,网站管理人员通过<font style="color:rgb(53, 53, 53);">manage.shopping.com</font>域名访问 Tomcat 去管理用户和商品,而用户管理和商品管理是两个单独的 Web 应用。终端客户通过<font style="color:rgb(53, 53, 53);">user.shopping.com</font>域名去搜索商品和下订单,搜索功能和订单管理也是两个独立的 Web 应用。
针对这样的部署,Tomcat 会创建一个 Service 组件和一个 Engine 容器组件,在 Engine 容器下创建两个 Host 子容器,在每个 Host 容器下创建两个 Context 子容器。由于一个 Web 应用通常有多个 Servlet,Tomcat 还会在每个 Context 容器里创建多个 Wrapper 子容器。每个容器都有对应的访问路径,你可以通过下面这张图来帮助你理解。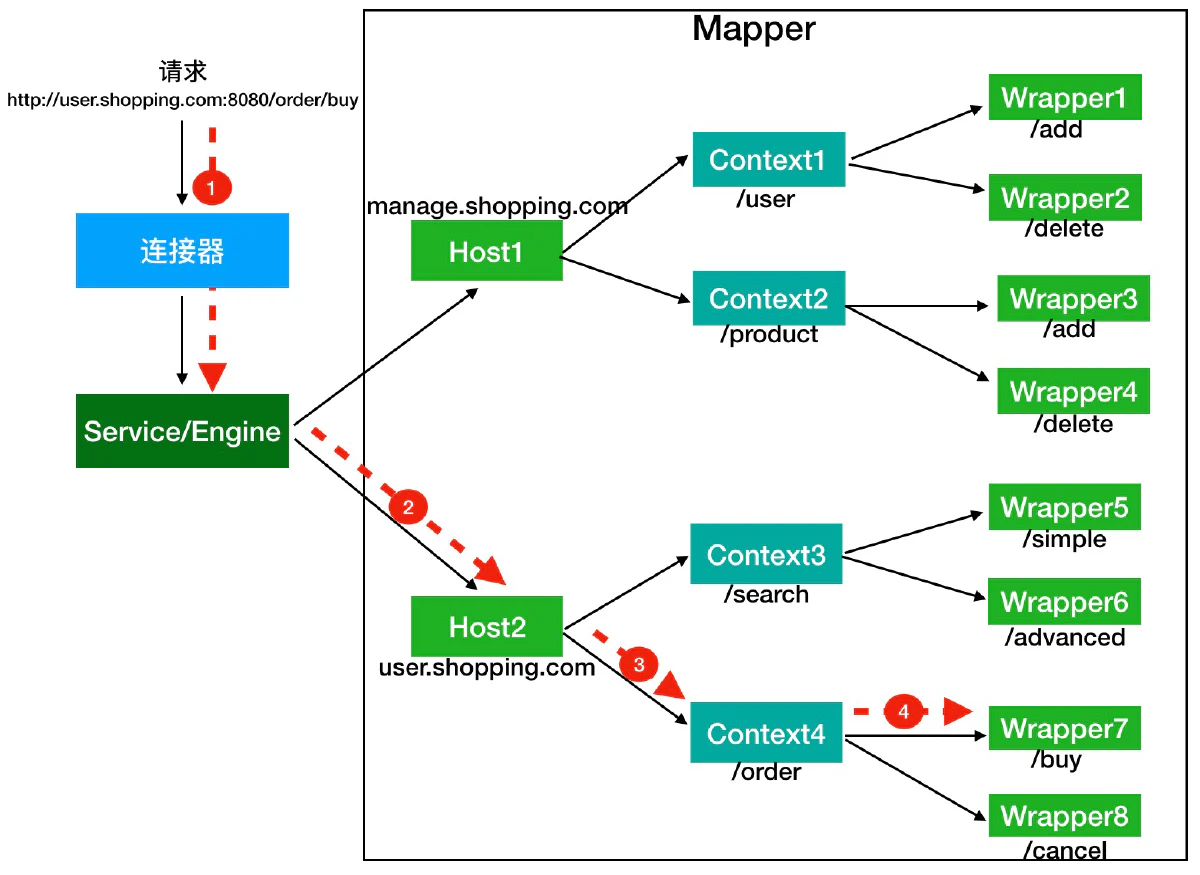
假如有用户访问一个 URL,比如图中的<font style="color:rgb(53, 53, 53);">http://user.shopping.com:8080/order/buy</font>,Tomcat 如何将这个 URL 定位到一个 Servlet 呢?
首先,根据协议和端口号选定 Service 和 Engine。
我们知道 Tomcat 的每个连接器都监听不同的端口,比如 Tomcat 默认的 HTTP 连接器监听 8080 端口、默认的 AJP 连接器监听 8009 端口。上面例子中的 URL 访问的是 8080 端口,因此这个请求会被 HTTP 连接器接收,而一个连接器是属于一个 Service 组件的,这样 Service 组件就确定了。我们还知道一个 Service 组件里除了有多个连接器,还有一个容器组件,具体来说就是一个 Engine 容器,因此 Service 确定了也就意味着 Engine 也确定了。
然后,根据域名选定 Host。
Service 和 Engine 确定后,Mapper 组件通过 URL 中的域名去查找相应的 Host 容器,比如例子中的 URL 访问的域名是<font style="color:rgb(53, 53, 53);">user.shopping.com</font>,因此 Mapper 会找到 Host2 这个容器。
之后,根据 URL 路径找到 Context 组件。
Host 确定以后,Mapper 根据 URL 的路径来匹配相应的 Web 应用的路径,比如例子中访问的是 /order,因此找到了 Context4 这个 Context 容器。
最后,根据 URL 路径找到 Wrapper(Servlet)。
Context 确定后,Mapper 再根据 web.xml 中配置的 Servlet 映射路径来找到具体的 Wrapper 和 Servlet。
看到这里,我想你应该已经了解了什么是容器,以及 Tomcat 如何通过一层一层的父子容器找到某个 Servlet 来处理请求。需要注意的是,并不是说只有 Servlet 才会去处理请求,实际上这个查找路径上的父子容器都会对请求做一些处理。我在上一期说过,连接器中的 Adapter 会调用容器的 Service 方法来执行 Servlet,最先拿到请求的是 Engine 容器,Engine 容器对请求做一些处理后,会把请求传给自己子容器 Host 继续处理,依次类推,最后这个请求会传给 Wrapper 容器,Wrapper 会调用最终的 Servlet 来处理。那么这个调用过程具体是怎么实现的呢?答案是使用 Pipeline-Valve 管道。
Pipeline-Valve 是责任链模式,责任链模式是指在一个请求处理的过程中有很多处理者依次对请求进行处理,每个处理者负责做自己相应的处理,处理完之后将再调用下一个处理者继续处理。
Valve 表示一个处理点,比如权限认证和记录日志。如果你还不太理解的话,可以来看看 Valve 和 Pipeline 接口中的关键方法。
public interface Valve {
  public Valve getNext();
  public void setNext(Valve valve);
  public void invoke(Request request, Response response)
}
由于 Valve 是一个处理点,因此 invoke 方法就是来处理请求的。注意到 Valve 中有 getNext 和 setNext 方法,因此我们大概可以猜到有一个链表将 Valve 链起来了。请你继续看 Pipeline 接口:
public interface Pipeline extends Contained {
    public void addValve(Valve valve);
    public Valve getBasic();
    public void setBasic(Valve valve);
    public Valve getFirst();
}
没错,Pipeline 中有 addValve 方法。Pipeline 中维护了 Valve 链表,Valve 可以插入到 Pipeline 中,对请求做某些处理。我们还发现 Pipeline 中没有 invoke 方法,因为整个调用链的触发是 Valve 来完成的,Valve 完成自己的处理后,调用 getNext.invoke() 来触发下一个 Valve 调用。
每一个容器都有一个 Pipeline 对象,只要触发这个 Pipeline 的第一个 Valve,这个容器里 Pipeline 中的 Valve 就都会被调用到。但是,不同容器的 Pipeline 是怎么链式触发的呢,比如 Engine 中 Pipeline 需要调用下层容器 Host 中的 Pipeline。
这是因为 Pipeline 中还有个 getBasic 方法。这个 BasicValve 处于 Valve 链表的末端,它是 Pipeline 中必不可少的一个 Valve,负责调用下层容器的 Pipeline 里的第一个 Valve。我还是通过一张图来解释。
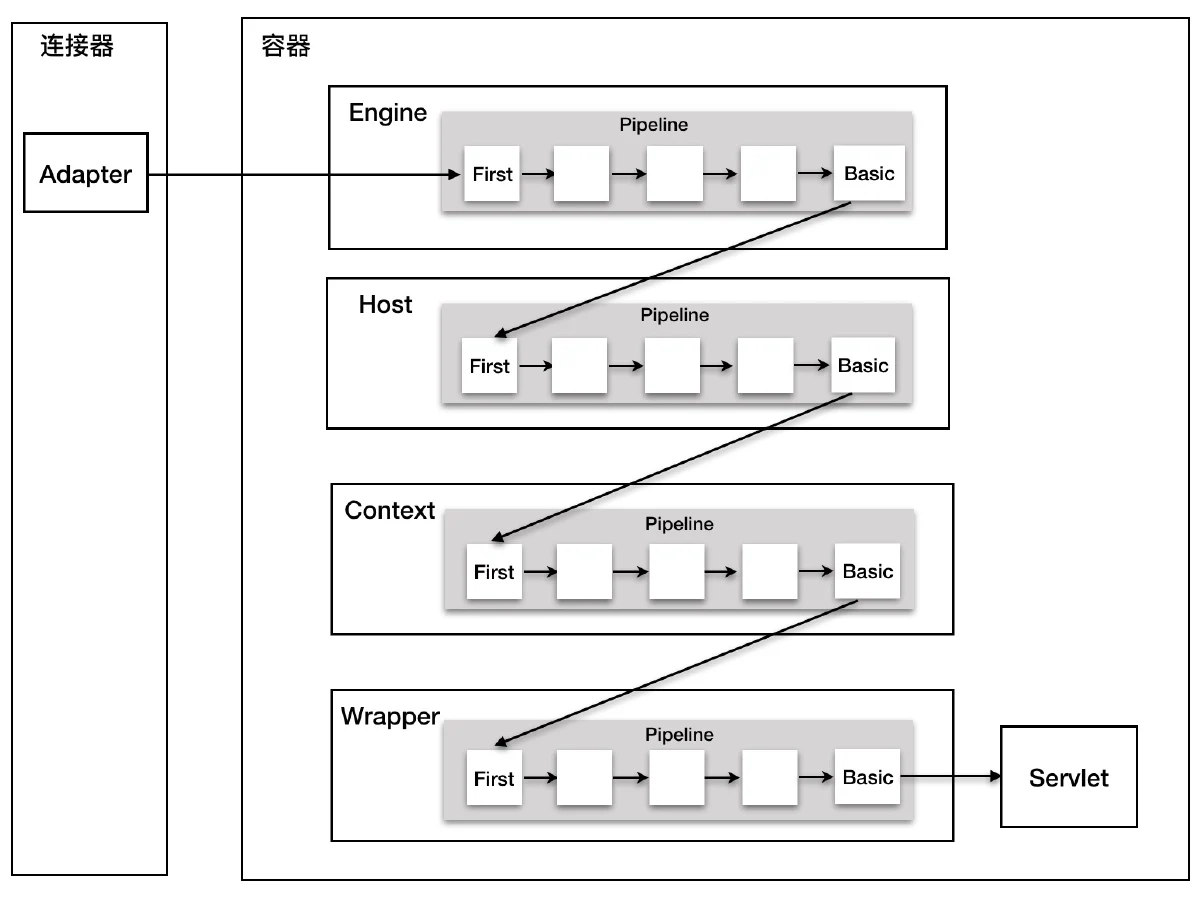
整个调用过程由连接器中的 Adapter 触发的,它会调用 Engine 的第一个 Valve:
// Calling the container
connector.getService().getContainer().getPipeline().getFirst().invoke(request, response);
Wrapper 容器的最后一个 Valve 会创建一个 Filter 链,并调用 doFilter() 方法,最终会调到 Servlet 的 service 方法。
你可能会问,前面我们不是讲到了 Filter,似乎也有相似的功能,那 Valve 和 Filter 有什么区别吗?它们的区别是:
- Valve 是 Tomcat 的私有机制,与 Tomcat 的基础架构 /API 是紧耦合的。Servlet API 是公有的标准,所有的 Web 容器包括 Jetty 都支持 Filter 机制。
- 另一个重要的区别是 Valve 工作在 Web 容器级别,拦截所有应用的请求;而 Servlet Filter 工作在应用级别,只能拦截某个 Web 应用的所有请求。如果想做整个 Web 容器的拦截器,必须通过 Valve 来实现。
总结一下
今天我们学习了 Tomcat 容器的层次结构、根据请求定位 Servlet 的过程,以及请求在容器中的调用过程。Tomcat 设计了多层容器是为了灵活性的考虑,灵活性具体体现在一个 Tomcat 实例(Server)可以有多个 Service,每个 Service 通过多个连接器监听不同的端口,而一个 Service 又可以支持多个虚拟主机。一个 URL 网址可以用不同的主机名、不同的端口和不同的路径来访问特定的 Servlet 实例。
请求的链式调用是基于 Pipeline-Valve 责任链来完成的,这样的设计使得系统具有良好的可扩展性,如果需要扩展容器本身的功能,只需要增加相应的 Valve 即可。
不错的问题
- 业务中的 controller 是怎么进来的
上一节就有过,Wrapper - Filter - DispatcherServlet - Controller - Tomcat 内的 Context 组件跟 Servlet 规范中的 ServletContext 接口有什么区别?跟 Spring 中的 ApplicationContext 又有什么关系?
| 组件 | 作用 | 生命周期 | 主要管理内容 | 关键方法 |
|---|---|---|---|---|
**Tomcat ****Context** | 表示一个 Web 应用 | 服务器启动时创建 | 负责 Servlet、Filter、Listener | addServlet(), getServletContext() |
**Servlet 规范 ****ServletContext** | Web 应用的全局上下文 | Web 应用启动时创建 | 共享资源、全局参数 | getAttribute(), getResourceAsStream() |
**Spring ****ApplicationContext** | Spring 容器的上下文 | Spring 容器启动时创建 | 依赖注入、Bean 管理 | getBean(), publishEvent() |
tomcat 跑起来之后会发生什么
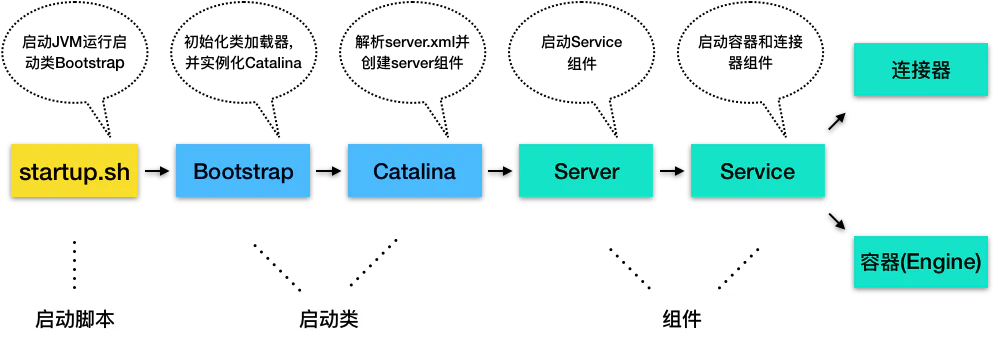
- Tomcat 本质上是一个 Java 程序,因此 startup.sh 脚本会启动一个 JVM 来运行 Tomcat 的启动类 Bootstrap。
- Bootstrap 的主要任务是初始化 Tomcat 的类加载器,并且创建 Catalina。关于 Tomcat 为什么需要自己的类加载器,我会在专栏后面详细介绍。
- Catalina 是一个启动类,它通过解析 server.xml、创建相应的组件,并调用 Server 的 start 方法。
- Server 组件的职责就是管理 Service 组件,它会负责调用 Service 的 start 方法。
- Service 组件的职责就是管理连接器和顶层容器 Engine,因此它会调用连接器和 Engine 的 start 方法。
Catalina
Catalina 的主要任务就是创建 Server,它不是直接 new 一个 Server 实例就完事了,而是需要解析 server.xml,把在 server.xml 里配置的各种组件一一创建出来,接着调用 Server 组件的 init 方法和 start 方法,这样整个 Tomcat 就启动起来了。作为“管理者”,Catalina 还需要处理各种“异常”情况,比如当我们通过“Ctrl + C”关闭 Tomcat 时,Tomcat 将如何优雅的停止并且清理资源呢?因此 Catalina 在 JVM 中注册一个“关闭钩子”。
public void start() {
    //1. 如果持有的 Server 实例为空,就解析 server.xml 创建出来
    if (getServer() == null) {
        load();
    }
    //2. 如果创建失败,报错退出
    if (getServer() == null) {
        log.fatal(sm.getString("catalina.noServer"));
        return;
    }

    //3. 启动 Server
    try {
        getServer().start();
    } catch (LifecycleException e) {
        return;
    }

    // 创建并注册关闭钩子
    if (useShutdownHook) {
        if (shutdownHook == null) {
            shutdownHook = new CatalinaShutdownHook();
        }
        Runtime.getRuntime().addShutdownHook(shutdownHook);
    }

    // 用 await 方法监听停止请求
    if (await) {
        await();
        stop();
    }
}
那什么是“关闭钩子”,它又是做什么的呢?如果我们需要在 JVM 关闭时做一些清理工作,比如将缓存数据刷到磁盘上,或者清理一些临时文件,可以向 JVM 注册一个“关闭钩子”。“关闭钩子”其实就是一个线程,JVM 在停止之前会尝试执行这个线程的 run 方法。下面我们来看看 Tomcat 的“关闭钩子”CatalinaShutdownHook 做了些什么。
protected class CatalinaShutdownHook extends Thread {

    @Override
    public void run() {
        try {
            if (getServer() != null) {
                Catalina.this.stop();
            }
        } catch (Throwable ex) {
           ...
        }
    }
}
从这段代码中你可以看到,Tomcat 的“关闭钩子”实际上就执行了 Server 的 stop 方法,Server 的 stop 方法会释放和清理所有的资源。
Server 组件
Server 组件的具体实现类是 StandardServer,我们来看下 StandardServer 具体实现了哪些功能。Server 继承了 LifeCycleBase,它的生命周期被统一管理,并且它的子组件是 Service,因此它还需要管理 Service 的生命周期,也就是说在启动时调用 Service 组件的启动方法,在停止时调用它们的停止方法。Server 在内部维护了若干 Service 组件,它是以数组来保存的,那 Server 是如何添加一个 Service 到数组中的呢?
@Override
public void addService(Service service) {

    service.setServer(this);

    synchronized (servicesLock) {
        // 创建一个长度 +1 的新数组
        Service results[] = new Service[services.length + 1];

        // 将老的数据复制过去
        System.arraycopy(services, 0, results, 0, services.length);
        results[services.length] = service;
        services = results;

        // 启动 Service 组件
        if (getState().isAvailable()) {
            try {
                service.start();
            } catch (LifecycleException e) {
                // Ignore
            }
        }

        // 触发监听事件
        support.firePropertyChange("service", null, service);
    }

}
从上面的代码你能看到,它并没有一开始就分配一个很长的数组,而是在添加的过程中动态地扩展数组长度,当添加一个新的 Service 实例时,会创建一个新数组并把原来数组内容复制到新数组,这样做的目的其实是为了节省内存空间。
除此之外,Server 组件还有一个重要的任务是启动一个 Socket 来监听停止端口,这就是为什么你能通过 shutdown 命令来关闭 Tomcat。不知道你留意到没有,上面 Caralina 的启动方法的最后一行代码就是调用了 Server 的 await 方法。
在 await 方法里会创建一个 Socket 监听 8005 端口,并在一个死循环里接收 Socket 上的连接请求,如果有新的连接到来就建立连接,然后从 Socket 中读取数据;如果读到的数据是停止命令“SHUTDOWN”,就退出循环,进入 stop 流程。
service 组件
Service 组件的具体实现类是 StandardService,我们先来看看它的定义以及关键的成员变量。
public class StandardService extends LifecycleBase implements Service {
    // 名字
    private String name = null;

    //Server 实例
    private Server server = null;

    // 连接器数组
    protected Connector connectors[] = new Connector[0];
    private final Object connectorsLock = new Object();

    // 对应的 Engine 容器
    private Engine engine = null;

    // 映射器及其监听器
    protected final Mapper mapper = new Mapper();
    protected final MapperListener mapperListener = new MapperListener(this);
StandardService 继承了 LifecycleBase 抽象类,此外 StandardService 中还有一些我们熟悉的组件,比如 Server、Connector、Engine 和 Mapper。
那为什么还有一个 MapperListener?这是因为 Tomcat 支持热部署,当 Web 应用的部署发生变化时,Mapper 中的映射信息也要跟着变化,MapperListener 就是一个监听器,它监听容器的变化,并把信息更新到 Mapper 中,这是典型的观察者模式。
作为“管理”角色的组件,最重要的是维护其他组件的生命周期。此外在启动各种组件时,要注意它们的依赖关系,也就是说,要注意启动的顺序。我们来看看 Service 启动方法:
protected void startInternal() throws LifecycleException {

//1. 触发启动监听器
setState(LifecycleState.STARTING);

//2. 先启动 Engine,Engine 会启动它子容器
if (engine != null) {
    synchronized (engine) {
        engine.start();
    }
}

//3. 再启动 Mapper 监听器
mapperListener.start();

//4. 最后启动连接器,连接器会启动它子组件,比如 Endpoint
synchronized (connectorsLock) {
    for (Connector connector: connectors) {
        if (connector.getState() != LifecycleState.FAILED) {
            connector.start();
        }
    }
}
}
从启动方法可以看到,Service 先启动了 Engine 组件,再启动 Mapper 监听器,最后才是启动连接器。这很好理解,因为内层组件启动好了才能对外提供服务,才能启动外层的连接器组件。而 Mapper 也依赖容器组件,容器组件启动好了才能监听它们的变化,因此 Mapper 和 MapperListener 在容器组件之后启动。组件停止的顺序跟启动顺序正好相反的,也是基于它们的依赖关系。
Engine 组件
最后我们再来看看顶层的容器组件 Engine 具体是如何实现的。Engine 本质是一个容器,因此它继承了 ContainerBase 基类,并且实现了 Engine 接口。
public class StandardEngine extends ContainerBase implements Engine {
}
我们知道,Engine 的子容器是 Host,所以它持有了一个 Host 容器的数组,这些功能都被抽象到了 ContainerBase 中,ContainerBase 中有这样一个数据结构:
protected final HashMap<String, Container> children = new HashMap<>();
ContainerBase 用 HashMap 保存了它的子容器,并且 ContainerBase 还实现了子容器的“增删改查”,甚至连子组件的启动和停止都提供了默认实现,比如 ContainerBase 会用专门的线程池来启动子容器。
for (int i = 0; i < children.length; i++) {
   results.add(startStopExecutor.submit(new StartChild(children[i])));
}
所以 Engine 在启动 Host 子容器时就直接重用了这个方法。
那 Engine 自己做了什么呢?我们知道容器组件最重要的功能是处理请求,而 Engine 容器对请求的“处理”,其实就是把请求转发给某一个 Host 子容器来处理,具体是通过 Valve 来实现的。
通过前面的学习,我们知道每一个容器组件都有一个 Pipeline,而 Pipeline 中有一个基础阀(Basic Valve),而 Engine 容器的基础阀定义如下:
final class StandardEngineValve extends ValveBase {

    public final void invoke(Request request, Response response)
      throws IOException, ServletException {

      // 拿到请求中的 Host 容器
      Host host = request.getHost();
      if (host == null) {
          return;
      }

      // 调用 Host 容器中的 Pipeline 中的第一个 Valve
      host.getPipeline().getFirst().invoke(request, response);
  }

}
这个基础阀实现非常简单,就是把请求转发到 Host 容器。你可能好奇,从代码中可以看到,处理请求的 Host 容器对象是从请求中拿到的,请求对象中怎么会有 Host 容器呢?这是因为请求到达 Engine 容器中之前,Mapper 组件已经对请求进行了路由处理,Mapper 组件通过请求的 URL 定位了相应的容器,并且把容器对象保存到了请求对象中。
总结一下
今天我们学习了 Tomcat 启动过程,具体是由启动类和“高层”组件来完成的,它们都承担着“管理”的角色,负责将子组件创建出来,并把它们拼装在一起,同时也掌握子组件的“生杀大权”。
所以当我们在设计这样的组件时,需要考虑两个方面:
首先要选用合适的数据结构来保存子组件,比如 Server 用数组来保存 Service 组件,并且采取动态扩容的方式,这是因为数组结构简单,占用内存小;再比如 ContainerBase 用 HashMap 来保存子容器,虽然 Map 占用内存会多一点,但是可以通过 Map 来快速的查找子容器。因此在实际的工作中,我们也需要根据具体的场景和需求来选用合适的数据结构。
其次还需要根据子组件依赖关系来决定它们的启动和停止顺序,以及如何优雅的停止,防止异常情况下的资源泄漏。这正是“管理者”应该考虑的事情。
不错的问题
- Server 组件的在启动连接器和容器时,都分别加了锁,这是为什么呢?
当然是因为用了线程不安全的数据结构
- tomcat 生产环境的线程数大小建议怎么设置
理论上:
线程数=((线程阻塞时间 + 线程忙绿时间) / 线程忙碌时间) * cpu核数
如果线程始终不阻塞,一直忙碌,会一直占用一个CPU核,因此可以直接设置 线程数=CPU核数。
但是现实中线程可能会被阻塞,比如等待IO。因此根据上面的公式确定线程数。
【非常重要】从Tomcat和Jetty中提炼组件化设计规范
那 Web 容器如何实现这种组件化设计呢?我认为有两个要点:
- 第一个是面向接口编程。我们需要对系统的功能按照“高内聚、低耦合”的原则进行拆分,每个组件都有相应的接口,组件之间通过接口通信,这样就可以方便地替换组件了。比如我们可以选择不同连接器类型,只要这些连接器组件实现同一个接口就行。
- 第二个是 Web 容器提供一个载体把组件组装在一起工作。组件的工作无非就是处理请求,因此容器通过责任链模式把请求依次交给组件去处理。对于用户来说,我只需要告诉 Web 容器由哪些组件来处理请求。把组件组织起来需要一个“管理者”,这就是为什么 Tomcat 和 Jetty 都有一个 Server 的概念,Server 就是组件的载体,Server 里包含了连接器组件和容器组件;容器还需要把请求交给各个子容器组件去处理,Tomcat 和 Jetty 都是责任链模式来实现的。
用户通过配置来组装组件,跟 Spring 中 Bean 的依赖注入相似。Spring 的用户可以通过配置文件或者注解的方式来组装 Bean,Bean 与 Bean 的依赖关系完全由用户自己来定义。这一点与 Web 容器不同,Web 容器中组件与组件之间的关系是固定的,比如 Tomcat 中 Engine 组件下有 Host 组件、Host 组件下有 Context 组件等,但你不能在 Host 组件里“注入”一个 Wrapper 组件,这是由于 Web 容器本身的功能来决定的。
组件的创建
由于组件是可以配置的,Web 容器在启动之前并不知道要创建哪些组件,也就是说,不能通过硬编码的方式来实例化这些组件,而是需要通过反射机制来动态地创建。具体来说,Web 容器不是通过 new 方法来实例化组件对象的,而是通过 Class.forName 来创建组件。无论哪种方式,在实例化一个类之前,Web 容器需要把组件类加载到 JVM,这就涉及一个类加载的问题,Web 容器设计了自己类加载器。
Spring 也是通过反射机制来动态地实例化 Bean,那么它用到的类加载器是从哪里来的呢?Web 容器给每个 Web 应用创建了一个类加载器,Spring 用到的类加载器是 Web 容器传给它的。
组件的生命周期管理
不同类型的组件具有父子层次关系,父组件处理请求后再把请求传递给某个子组件。而 Tomcat 通过容器的概念,把小容器放到大容器来实现父子关系,其实它们的本质都是一样的。这其实涉及如何统一管理这些组件,如何做到一键式启停。
Tomcat 和 Jetty 都采用了类似的办法来管理组件的生命周期,主要有两个要点,一是父组件负责子组件的创建、启停和销毁。这样只要启动最上层组件,整个 Web 容器就被启动起来了,也就实现了一键式启停;二是 Tomcat 和 Jetty 都定义了组件的生命周期状态,并且把组件状态的转变定义成一个事件,一个组件的状态变化会触发子组件的变化,比如 Host 容器的启动事件里会触发 Web 应用的扫描和加载,最终会在 Host 容器下创建相应的 Context 容器,而 Context 组件的启动事件又会触发 Servlet 的扫描,进而创建 Wrapper 组件。那么如何实现这种联动呢?答案是观察者模式。具体来说就是创建监听器去监听容器的状态变化,在监听器的方法里去实现相应的动作,这些监听器其实是组件生命周期过程中的“扩展点”。
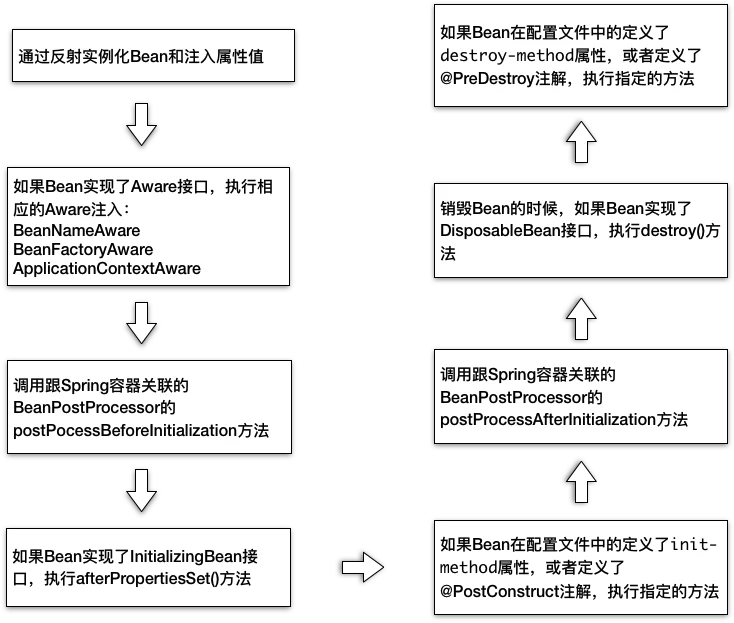
Spring 也采用了类似的设计,Spring 给 Bean 生命周期状态提供了很多的“扩展点”。这些扩展点被定义成一个个接口,只要你的 Bean 实现了这些接口,Spring 就会负责调用这些接口,这样做的目的就是,当 Bean 的创建、初始化和销毁这些控制权交给 Spring 后,Spring 让你有机会在 Bean 的整个生命周期中执行你的逻辑。下面我通过一张图帮你理解 Spring Bean 的生命周期过程:
组件的骨架抽象类和模板模式
具体到组件的设计的与实现,Tomcat 和 Jetty 都大量采用了骨架抽象类和模板模式。比如说 Tomcat 中 ProtocolHandler 接口,ProtocolHandler 有抽象基类 AbstractProtocol,它实现了协议处理层的骨架和通用逻辑,而具体协议也有抽象基类,比如 HttpProtocol 和 AjpProtocol。对于 Jetty 来说,Handler 接口之下有 AbstractHandler,Connector 接口之下有 AbstractorConnector,这些抽象骨架类实现了一些通用逻辑,并且会定义一些抽象方法,这些抽象方法由子类实现,抽象骨架类调用抽象方法来实现骨架逻辑。
这是一个通用的设计规范,不管是 Web 容器还是 Spring,甚至 JDK 本身都到处使用这种设计,比如 Java 集合中的 AbstractSet、AbstractMap 等。 值得一提的是,从 Java 8 开始允许接口有 default 方法,这样我们可以把抽象骨架类的通用逻辑放到接口中去。
优化并提高Tomcat启动速度(知道即可)
太细了,我没有看。
不过,我觉得我作为后端开发而言,对于 tomcat 的启动速度并不是太关系。
对于 spring boot 内嵌的 tomcat 而言,可以通过在Springboot里配置文章里提到的那些参数,比如:server.tomcat.additional-tld-skip-patterns: xxx*.jar或者通过TomcatServletWebServerFactory来修改参数
  @Bean
  public TomcatServletWebServerFactory tomcatFactory() {
    return new TomcatServletWebServerFactory() {
      @Override
      protected void postProcessContext(Context context) {
        ((StandardJarScanner) context.getJarScanner()).setScanManifest(false);
      }
    };
  }